- yyf2026-09-03
 主楼
- DeaBingFeng2026-09-04
- Tom_Cat2026-09-04
天才!!!建议申遗。这是绝对的天才想法
- 莫道2026-09-04
那我可以将1个4K视频压缩到几个字节之内
- geng2026-09-04
有点像古早时期存多模态数据,是用识图模型生成描述文本再做Embedding
- renty2026-09-04
- gurupuru2026-09-04
你好,AI,我要看“簧片”
- Lithium2026-09-04
局部补全或许真的可以成为一种压缩思路
- youguess2026-09-04
- Rong2026-09-04
哇,太好了,是全损压缩,我的老照片有救了(
- GPLer-linuxdo2026-09-04
讲道理没毛病,不要求通用的情况下,通过有限描述就可以以近似表述的方式确定一张照片且不改变意思,毕竟一张照片携带的对人来说有效的信息量确实不需要占用这么大空间,这并不违反信息论。
想起了这个
https://zhuanlan.zhihu.com/p/694711038
FFmpeg之父新作——音频压缩工具 TSAC
其原理和我们之前介绍的突破压缩极限的AI语音编解码器类似,使用深度学习网络进行压缩,TSAC这里引入Transformer结构来提升性能。
- 吃风筝的人2026-09-04
但有一个问题, ai还原照片消耗的实时算力成本和照片本身的体积成本如何比较? 而且概率模型的随机性问题如何解决? 而且细节信息被大量损失. 文字可以如此准确描述图片所有信息吗?
我不了解压缩算法, 但这方法第一眼看过去有一种说不上来的奇怪
- r_earth_or2026-09-04
- uid95272026-09-04
违反信息论的,计算不可约信息全丢了
- r_earth_or2026-09-04
这个方案的前提就是容许图片内容在复原时存在大量信息丢失,但是只要和大脑里的差不多,就认为图片是对的
- GPLer-linuxdo2026-09-04
注意我们的目的不是传输照片,我们的目的是传输照片所表达的信息,信息本身远小于照片体积,就传输照片所表达的信息而言,压缩成立且不违反信息论,只要表述的足够精确,解压(绘图)理论上并不影响信息表达
- Lithium2026-09-04
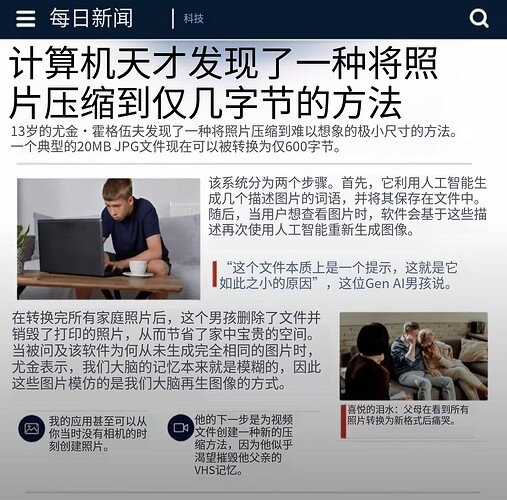
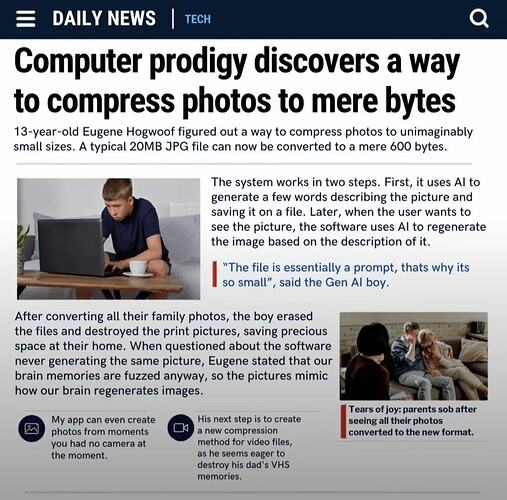
例如主楼中的图片只保留两张人物图,其他的都用AI生成并拼接
- GPLer-linuxdo2026-09-04
站在信息传递而非无损压缩的角度,这种方式压缩等级开高后,理论上都不需要包含配图信息 ^-^
- 远坂凛的宠物2026-09-04
在上一波ai热生图还靠gan的时候就有这个思路了,我记得还集成进chrome了吧
- SwiftUI2026-09-04
模型也是有很多信息的 你问llm一些知识他不也能正确回答 虽然和原始训练数据肯定不一样但是大部分情况回答都是对的