- 九只猫2026-09-07
RT,一个20X只够用两天,用的Astra中等智商。
现在考虑开第二个号了,还有什么好的建议吗
主楼 - Coeus2026-09-07
如果你只是纯coding写代码,这件事情用Astra或者Fable级别的模型有点浪费了,写好文档规划,剩下执行可以用更弱的模型,没必要用大炮打蚊子
- MicroSeg作者2026-09-07
全程astra顶不住的佬友,似乎coding plan比api还贵?那不如开api了,还不降智。
- appcloud2026-09-07
问一下 花出去200USD 能赚回来 200 * 30 倍的收益吗
- 三四2026-09-07
astra + terra,额度又坚挺了。不过能考虑开第二个号而不是考虑怎么省的,建议直接开号,有好的就吃好的
- Neptune2026-09-07
可是tibo吹Astra low都比sol high强,官方吹的也是Astra比sol完成一件任务更少额度,可惜Astra目前cache read双倍计费,导致Astra更贵
- 时牧2026-09-07
- chenggongas2026-09-07
再搞一个稳定的中转站备用 ^-^这样的话,就能撑到月底了
- Coeus2026-09-07
营销话术,不能全信,他吹自家的产品和公司也可以理解,人家是OpenAI的高管。但是咱们作为用户,还要分清哪些是营销话术,哪些是真实的。实践过就知道,完全没必要全程用Astra或者Fable级别的模型来写代码,他们设计好框架和规划,然后用更低级的模型做执行,更有性价比
- Neptune2026-09-07
太难受了,啥时候让Astra计费正常就好了,2.5sol还是可以接受的,但是5倍真架不住
- kunkun233-linuxdo2026-09-07
只是单价更贵,实际coding plan的性价比远高于api计价,200$的api,基本就打个水漂
- EmmaHill2026-09-07
一天一个20X时代 希望后续计费能优化
- EmmaHill2026-09-07
营销话术,不能全信,他吹自家的产品和公司也可以理解,人家是OpenAI的高管。但是咱们作为用户,还要分清哪些是营销话术,哪些是真实的。实践过就知道,完全没必要全程用Astra或者Fable级别的模型来写代码,他们设计好框架和规划,然后用更低级的模型做执行,更有性价比
直接在对话框里告诉Astra 用别的model来执行吗? 还有就是20万的context window频繁压缩起来好难受
- Coeus2026-09-07
你手动切换或者告诉他都可以,一般旗舰级模型只做规划,执行层用能力没有那么强的模型,可以修改的,改配置文件,改成1M上下文,可以的,你直接让它改就行,或者你手动去改配置文件
- EmmaHill2026-09-07
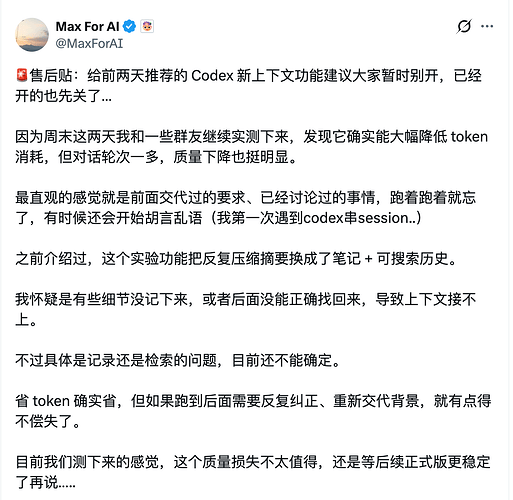
我开了那个号称无线上下文的实验功能,“
context_management = true”但是上下文窗口还是20万,改配置文件能实现跟API一样的真实1M context window吗?改配置文件,改成1M上下文,可以的,你直接让它改就行,或者你手动去改配置文件
- EmmaHill2026-09-07
你手动切换或者告诉他都可以,一般旗舰级模型只做规划,执行层用能力没有那么强的模型,可以修改的,改配置文件,改成1M上下文,可以的,你直接让它改就行,或者你手动去改配置文件
This has just been shared tonight by Tibo on Twitter
Here is how to enable a 1M-token context window in Codex for GPT-5.6 Sol.
Codex is tuned to use a context limit that balances performance and cost, but a larger context window is a common request, so here is how to configure it.
A larger context window lets Codex retain more code, tool output, and conversation history before summarizing older material. You need a model that supports it. GPT-5.6 Sol, for example, has a documented 1,050,000-token context window.
Open ~/.codex/config.toml and add or update these settings at the top level, before any [section] headers:
model = "gpt-5.6-sol"model_context_window = 1000000model_auto_compact_token_limit = 900000The first setting selects the model. The second tells Codex to use a one-million-token context budget. The third starts automatic history compaction around 900,000 tokens, leaving some headroom.
Restart the Codex client and start a new session after saving.
To try the configuration for a single CLI session without changing your defaults:
codex -m gpt-5.6-sol-c model_context_window=1000000-c model_auto_compact_token_limit=900000Have fun, but keep in mind that the default context limit has been tuned carefully for performance and cost.
- Coeus2026-09-07
- zanexu2026-09-07
有个叫 codexpro 开源项目,可以把 ChatGPT 和本地连接,从而达到使用 chat 的方式,访问,编辑本地文件。token0 消耗。佬可以试试。
- lingdada2026-09-07
如果只是做做业务开发,你用 Astra 6 那就是火箭打蚊子,我现在基本是 5.6 terra 在跑,只有整体架构规划会先用 6 跑一遍,具体干活就别找他了,你总不能写个表单都要用 Astra6 吧