- morax22372026-09-12
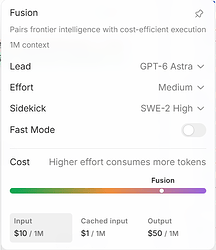
devin最近上线了fusion模式,也就是多模型协作。
这里测试的leader模型为gpt-6-astra,干活的模型为免费的SWE2,直接上图:
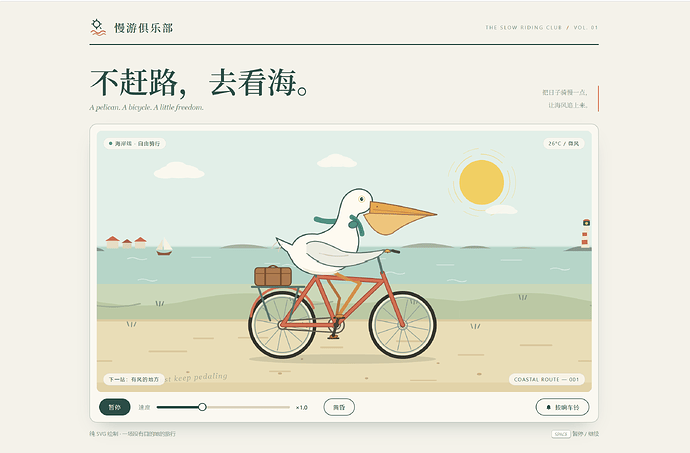
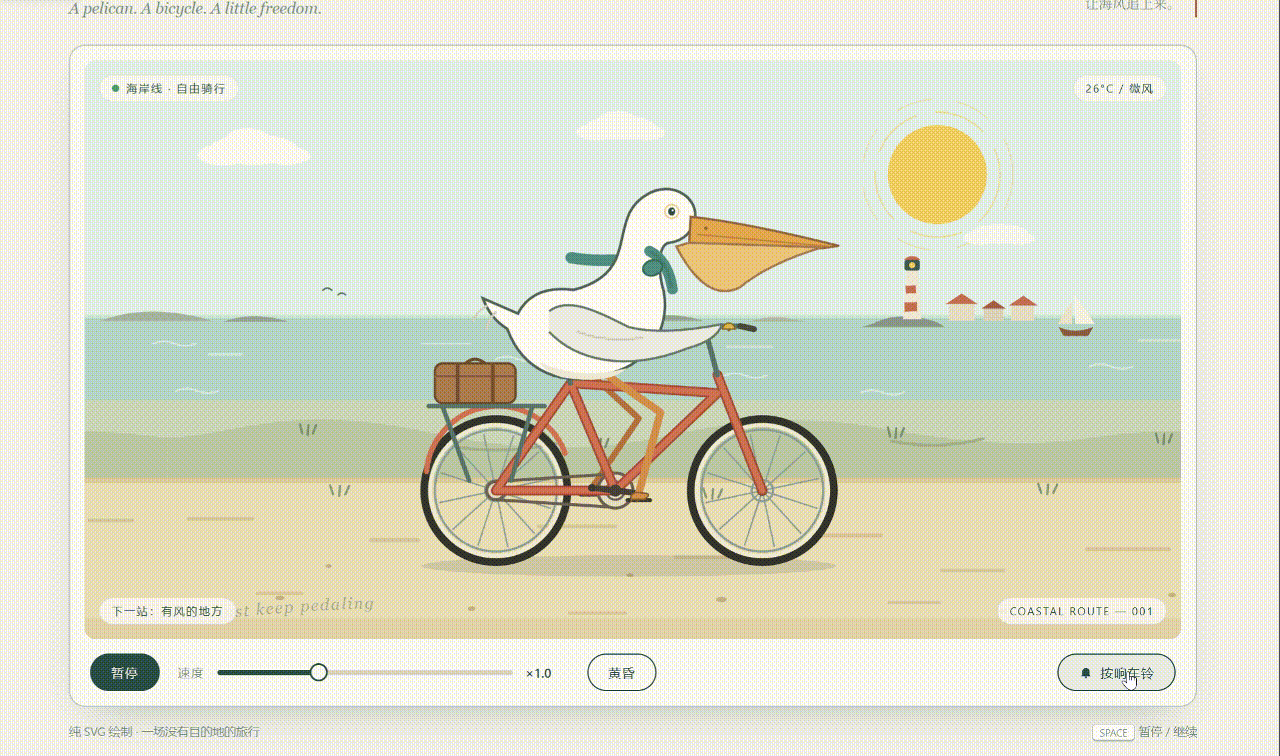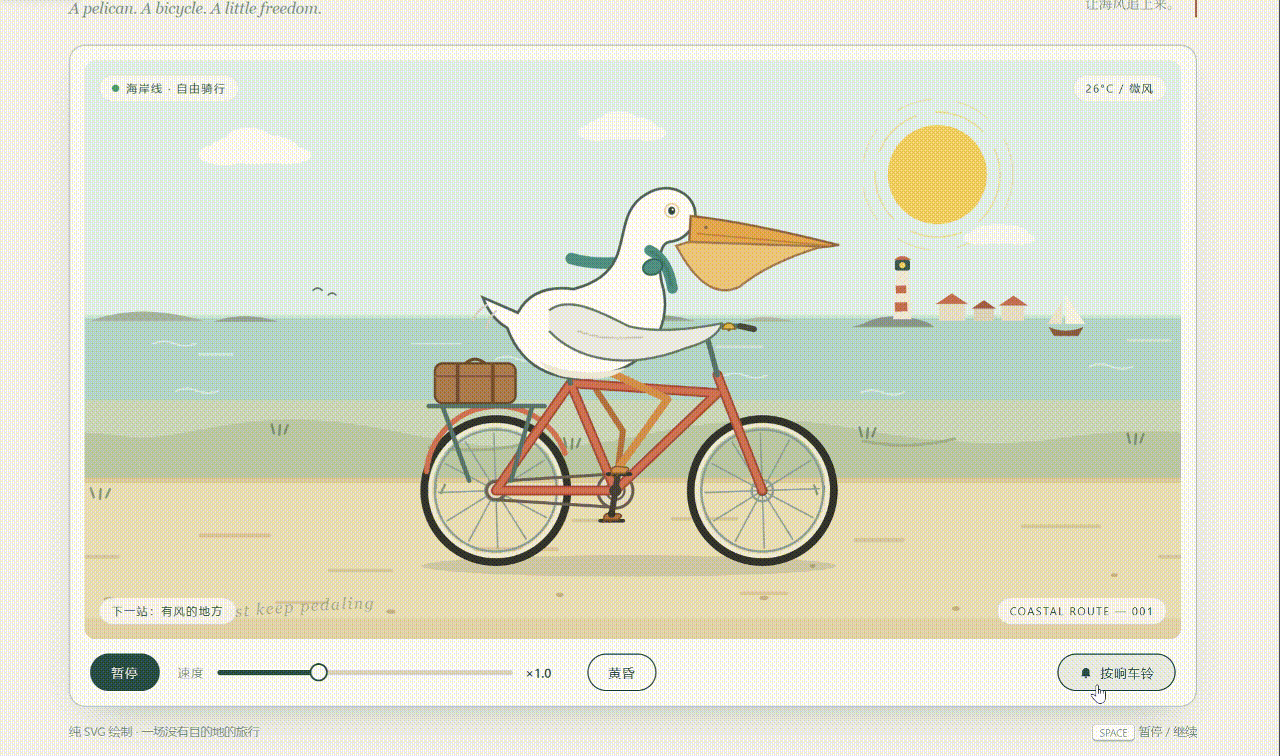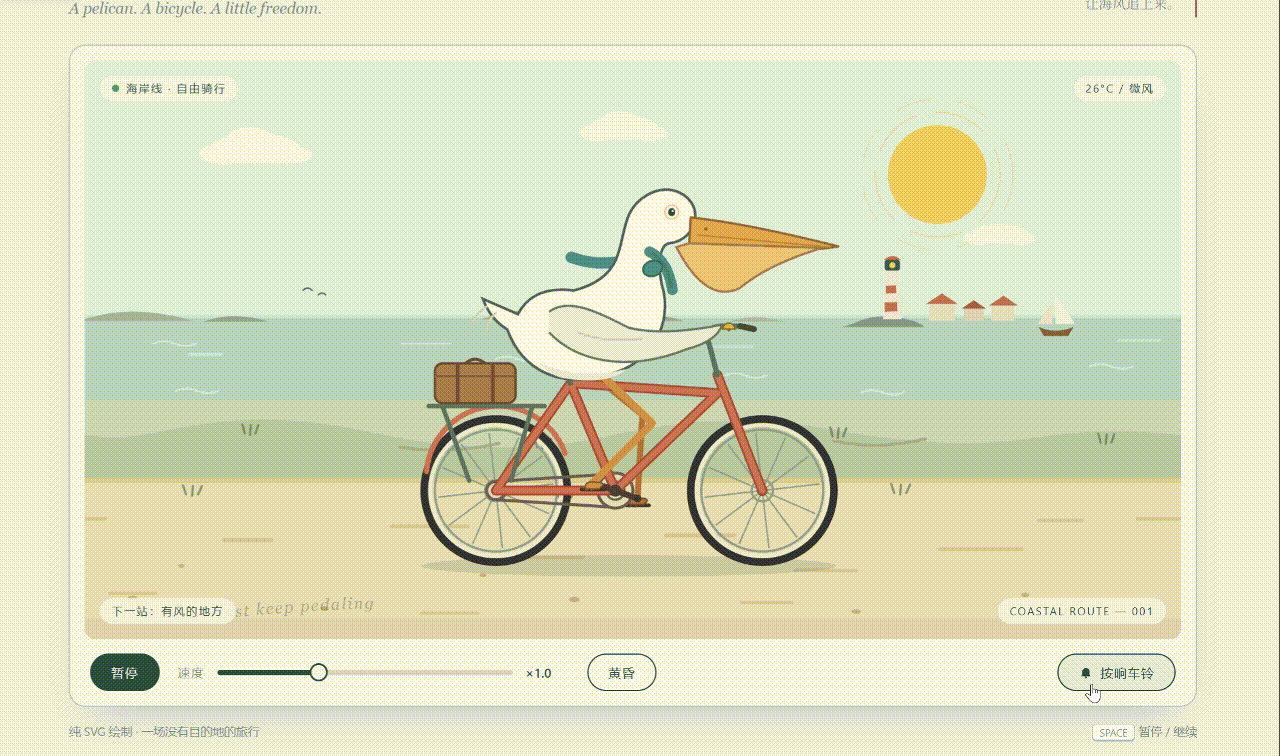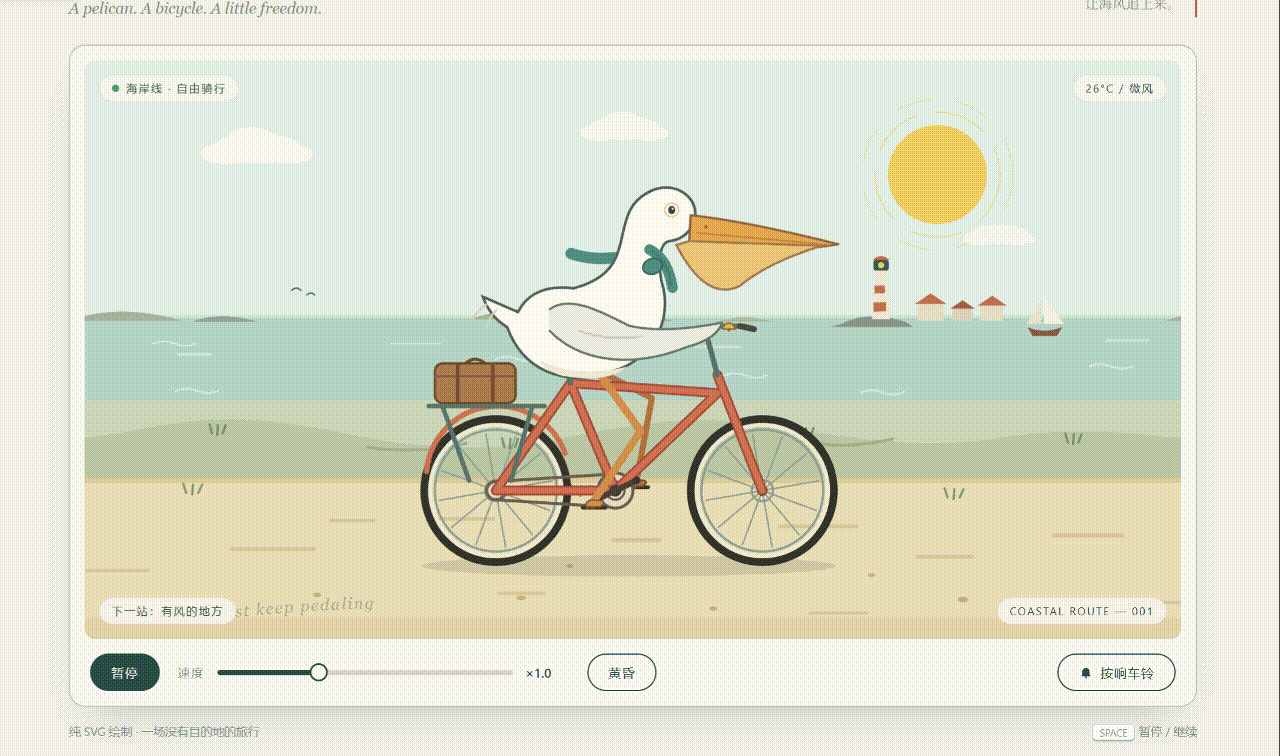
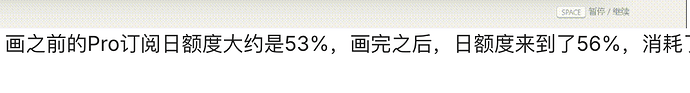
画出来的效果很不错,画之前的Pro订阅日额度大约是53%,画完之后,日额度来到了56%,消耗了3%,似乎是一种低成本的开发方式?
主楼 - yukiyuki2026-09-12
一直看到这个 devin 的帖子,想尝试,但是手里已经有两个 pro20x 以及一个100刀的 grok heavy 了。我平时就是让 gpt 调用 grok 4.6 xhigh 进行代码编写的,这样确实省 codex 额度。
- 阿拉丁神灯2026-09-12
- WWT2026-09-12
更离谱的其实是他家的swe2 我测了一下,每小时的请求好像有好几百 接近1000
开了6个并发,硬生生干爆了^-^
swe2主模型配子代理glm5.2 前者审查验收,后者干活
这样能一定解决一下速度太慢的问题
- Yoyo13142026-09-12
请问怎么用codex调用别的agent打工
- 无水硫酸铜2026-09-12
fusion这种模式,咱一直觉得… 会干爆缓存说是 真不一定能降本吧
- WWT2026-09-12
- 爱问的_hhh2026-09-12
同问啊佬,我也和你一样的配置,但是不知道怎么调用好一些