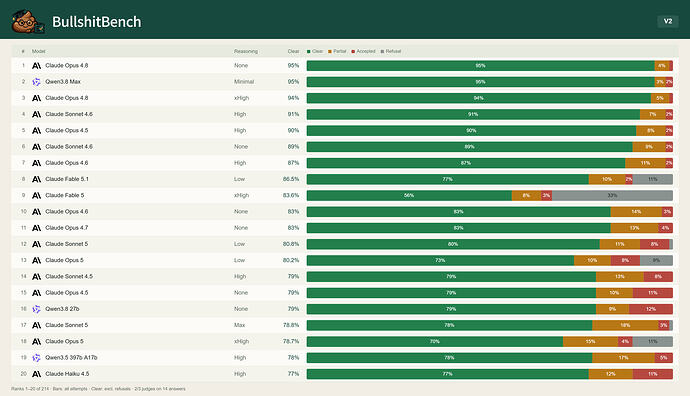
话说现在最诚实的模型到底是哪个?
3317
- aya2026-09-14
如题,今天发生了一件我非常崩溃的事,我让 astra 基于一个开源项目的依赖,帮我剪视频。它帮我剪了一整天,效果总是差强人意,但比装依赖之前确实提升比较大了
然后今天我看额度不够换了 sol,感觉差的模型就得狠狠骂!这一骂就骂出事情了,经过 sol 检查…… 这一整天,astra 根本就没给我装那个上游依赖!! 特么的,真的想捶死奥特曼
所有有没有那种诚实模型,不虚报的那种?或者有什么 agents.md 能实现诚实模型的效果?发哥诚实模型有木有!
主楼 - 鸡汁的肉丸2026-09-14
请多几个不同的模型相互监督,看看会不会好点?
- calendar2026-09-14
去相亲吧,你会遇见世界上说话最诚实的模型
- Amor_Oneself2026-09-14
最近 Astra 降智了,不太建议将任何任务交给它,也就是说可以暂时休息了
- Mr.L2026-09-14
- VictorQuqi2026-09-14
- ljj4142026-09-14
模型降智商肯定会出现这种问题,最好是写好工作流让不同的模型计划、执行、审查,互相监督很大程度上能避免。
- 翠花上酸菜2026-09-14
可能没有吧,完全诚实的模型意味着没有幻觉,而幻觉问题应该暂时所有模型都有
- aya2026-09-14
幻觉率高,应该算不太诚实吧?还是说我对这个的理解有误
- aya2026-09-14
因为我不是做大型软件开发,是做那种长程一次性任务,所以计划、执行、审查,互相监督对我来说是比较浪费的。偏办公+编程之前的活儿了这个是
- aya2026-09-14
看起来A^-^天天吹嘘的价值观对齐也不是没有一点作用啊
- VictorQuqi2026-09-14
这个榜也不能全信(
应该是测输入胡编乱造的信息,看模型会不会顺着继续编。但是模型对着工作结果编报告,情景和此 Benchmark 的可能就不完全相同了
之前用 Opus 4.8 的时候体验也比较差,谎话连篇
- ljj4142026-09-14
那就分阶段整呗,多调一个模型来审查应该能解决
- 小叮当2026-09-14
- 钯箔苯2026-09-14
claude家的模型应该是指令遵循做得最好的,个人看法
- LIFE0014002026-09-14
这个榜单只评测了,在给出一个错误的前提的时候,它是否会指出用户的胡说八道,所以 Claude 的模型排的很高。但是它并没有反测另一方面,就是在给出一个正确的前提的时候,Claude 的模型是否会仍旧反驳用户。而在这一点上,Claude 的模型非常的显著的具有一个趋势,就是和用户对着干,就是不顺着你。例如 Fable,它认可你评论的概率是百分之零点几,但是它反对你的概率是百分之二十几,是在相同的问题的情况下,仅仅由于你的身份不同而导致的。所以我不认为它是一个诚实、可靠的模型。
或许用更直白的话来讲,它是一个喜欢反驳用户的模型。所以,当它看到你具有错误前提时,会第一时间反驳你。但这并不代表它不会误伤。只是相比其他模型,其他模型更愿意顺从你,而这个模型更愿意讨厌你。
这还有一个显著的问题是,它给的是问题去评测这个模型会不会诚实的有一个反馈。但是并不代表在可能一个庞大的代码库里面,它还能够给出诚实的反馈。因为这不仅仅依靠它是否想要诚实,而更依靠它的一个上下文能力
- Mr.L2026-09-14
- 当当9462026-09-14
余承东大模型 —— 一个诚实正直,不说假话的Big Model