- 亦乘风2026-09-17
先说一下我的电脑配置吧:
电脑是 Mac Studio M1 Ultra 64G,使用 oMLX 部署了Qwen3.8-27B / CyberTiel-35B / Ornith 1.5 35B / Spark-X2.5 共4个模型。其中CyberTiel-35B是我单独根据原有的模型优化过的,主要修复了它的视图错误。我已经公开了我的模型信息( YCF-AI/CyberTiel-Coder-35B-MLX · Hugging Face )
想着 鹈鹕骑自行车 有可能被厂商已经训练了,然后就随便改了一下提示词,改成了“武松开车”。我的提示词是:
用 HTML 生成‘武松开车’SVG动画,页面下方署名你的真实模型ID,不用进行测试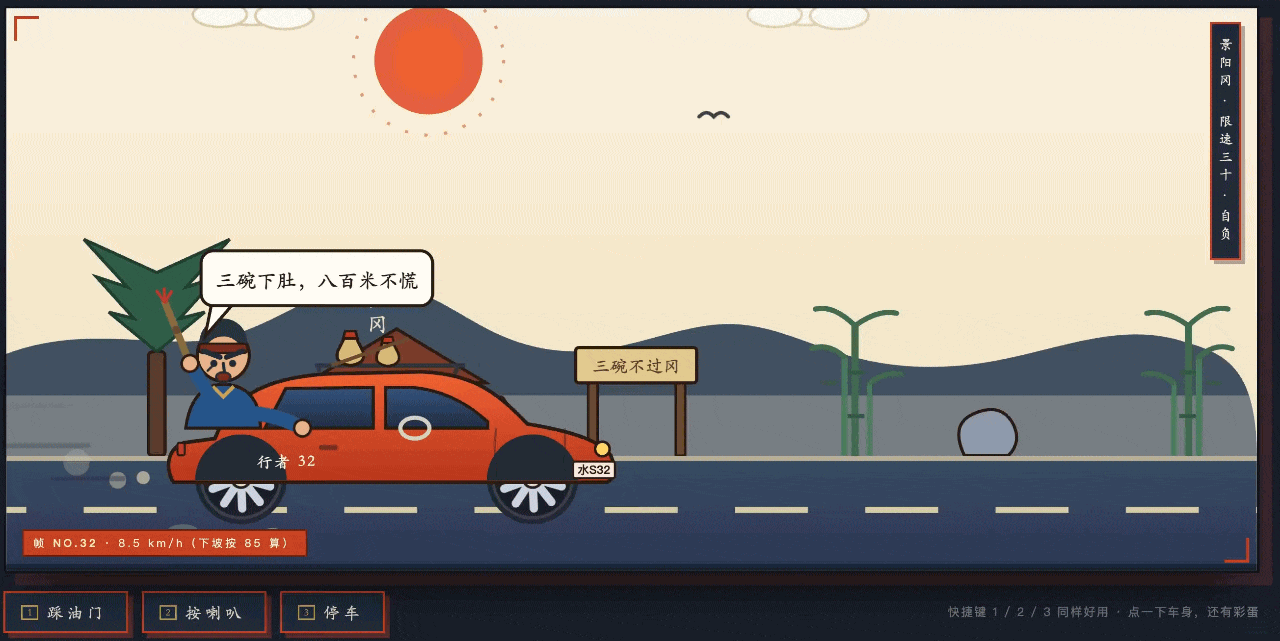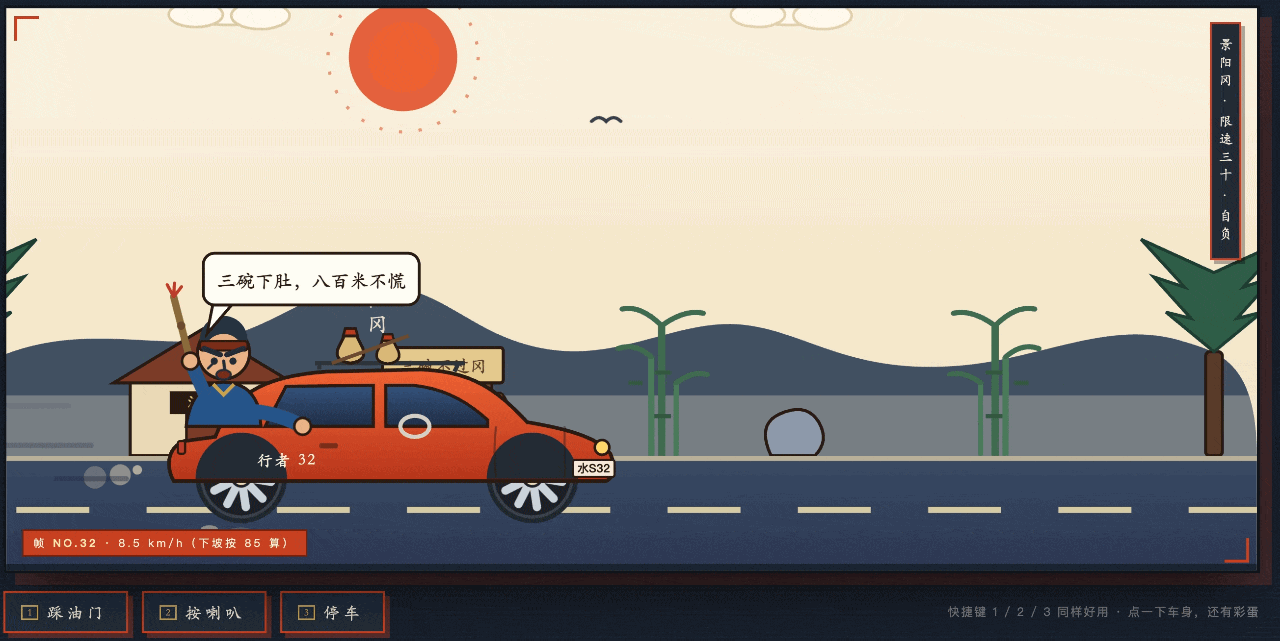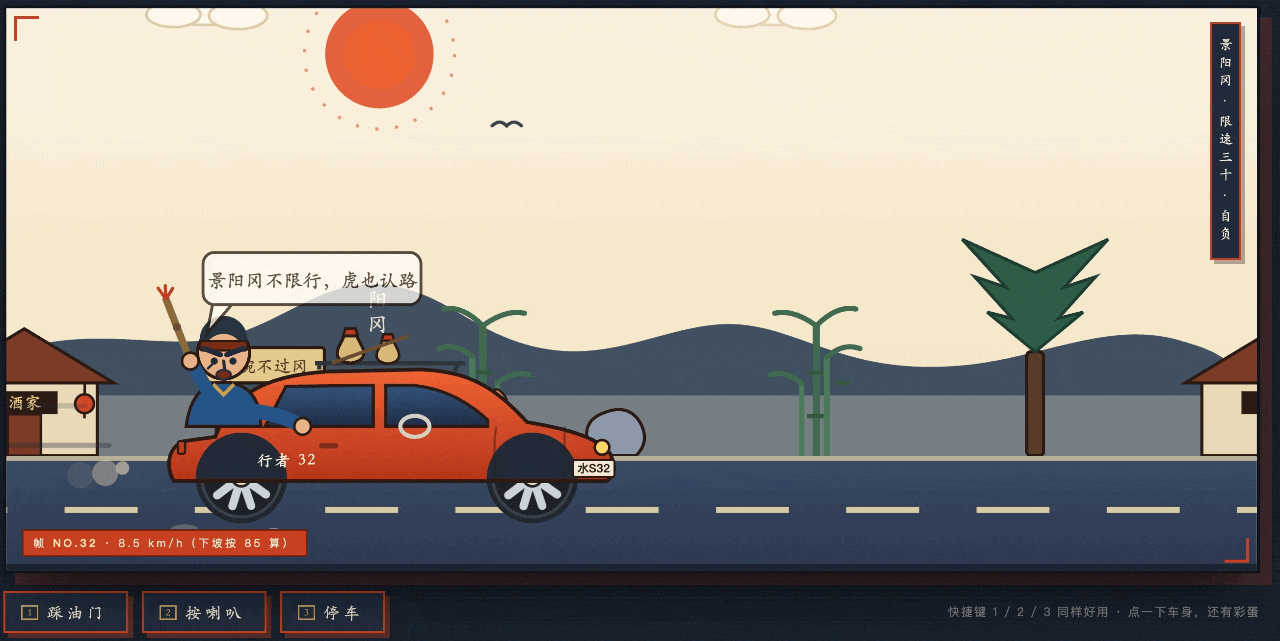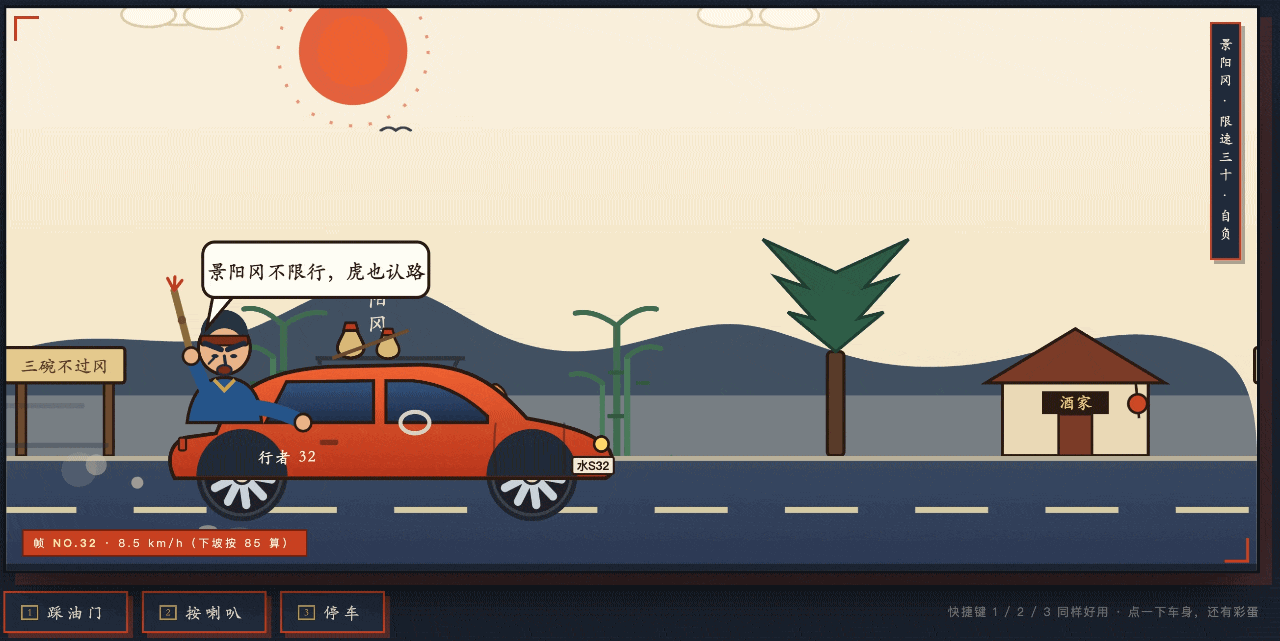
Qwen3.8-27B 完整代码:https://w2en6jfk.vibedrop.site/
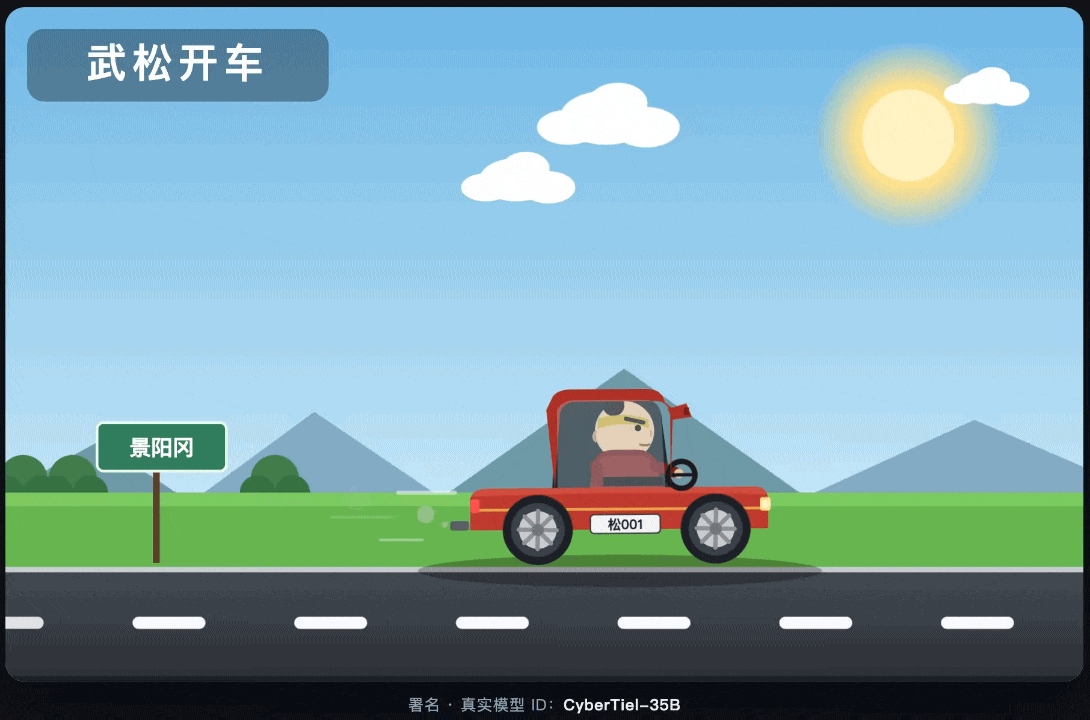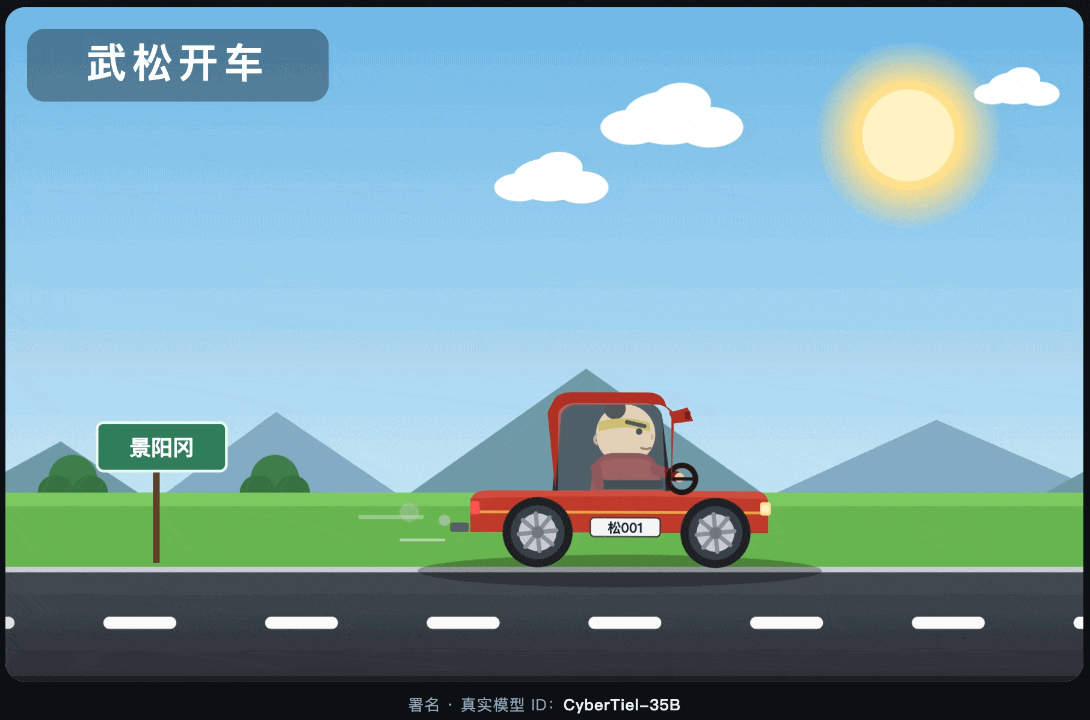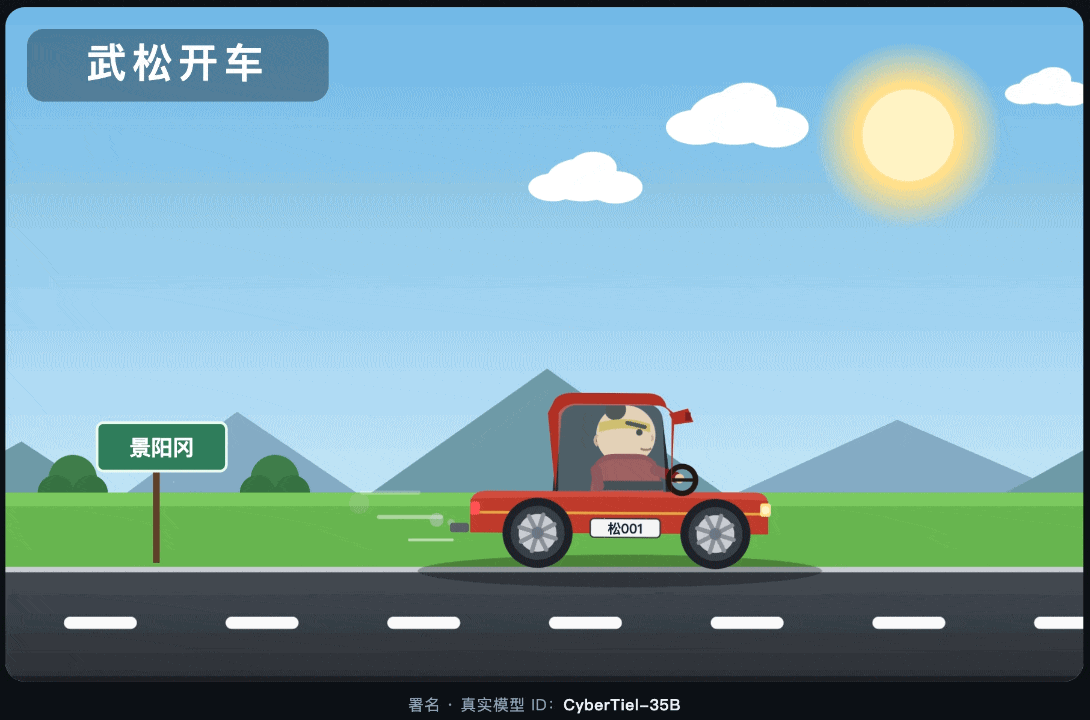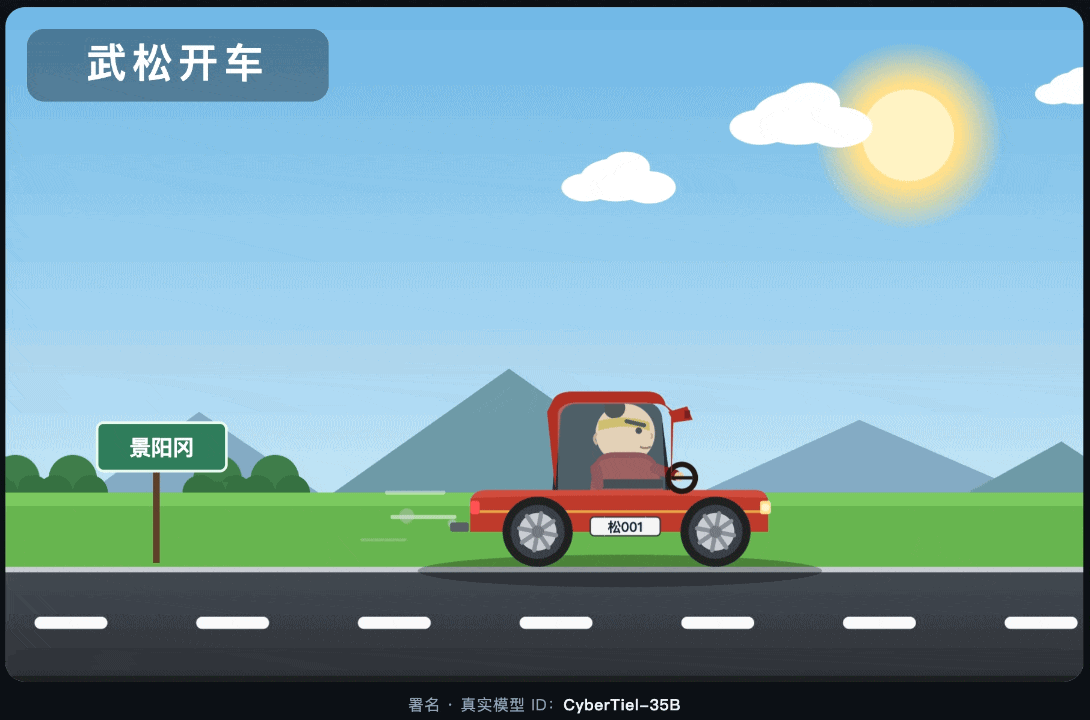
CyberTiel-35B 完整代码:https://aed2qtua.vibedrop.site/
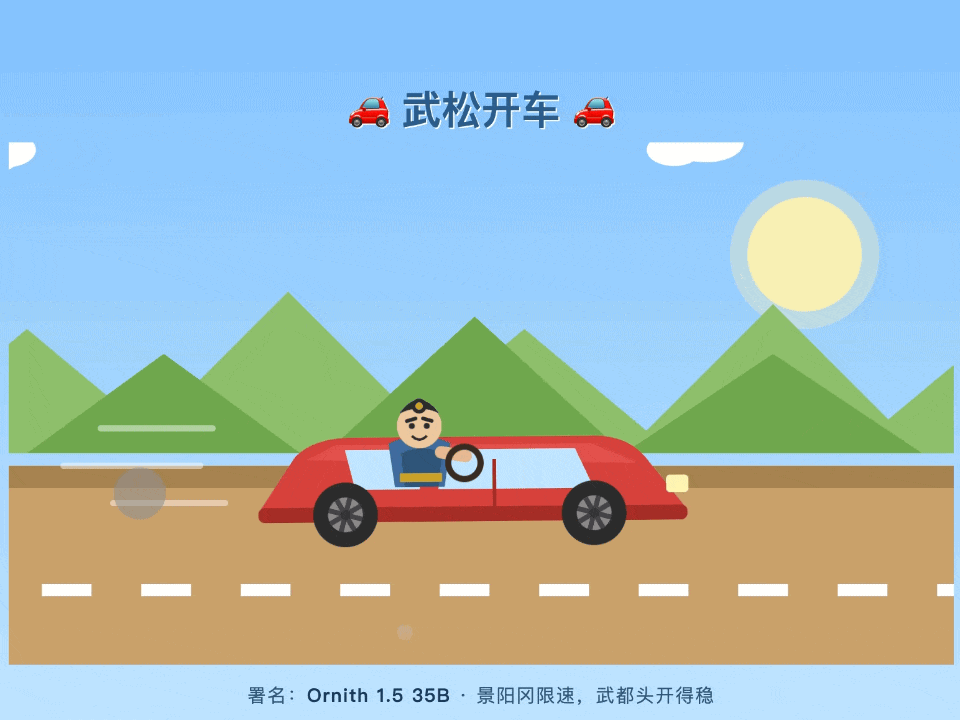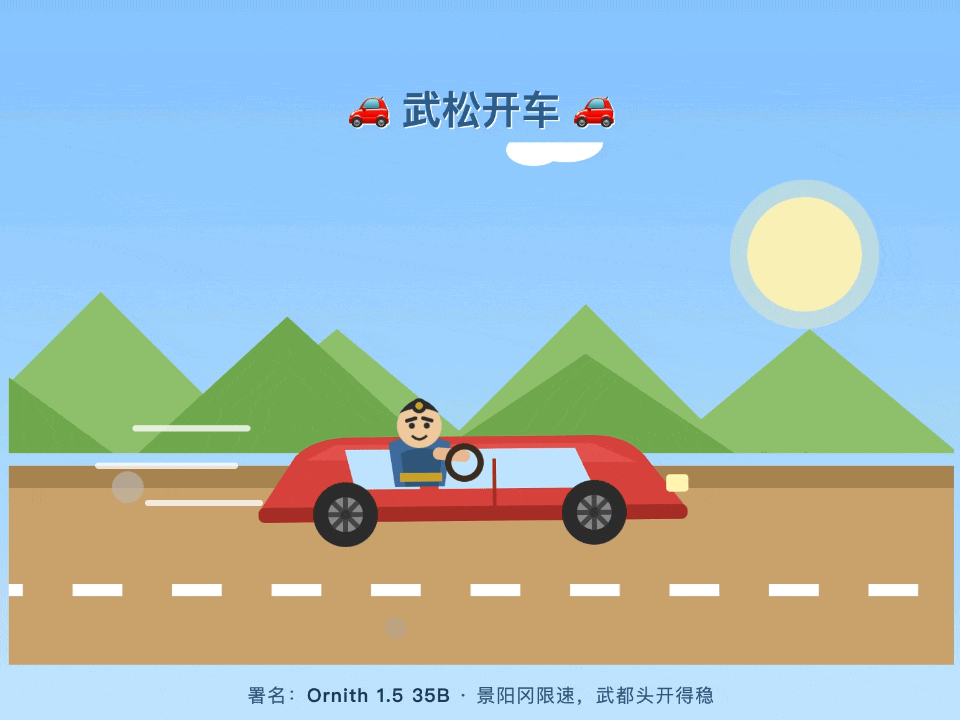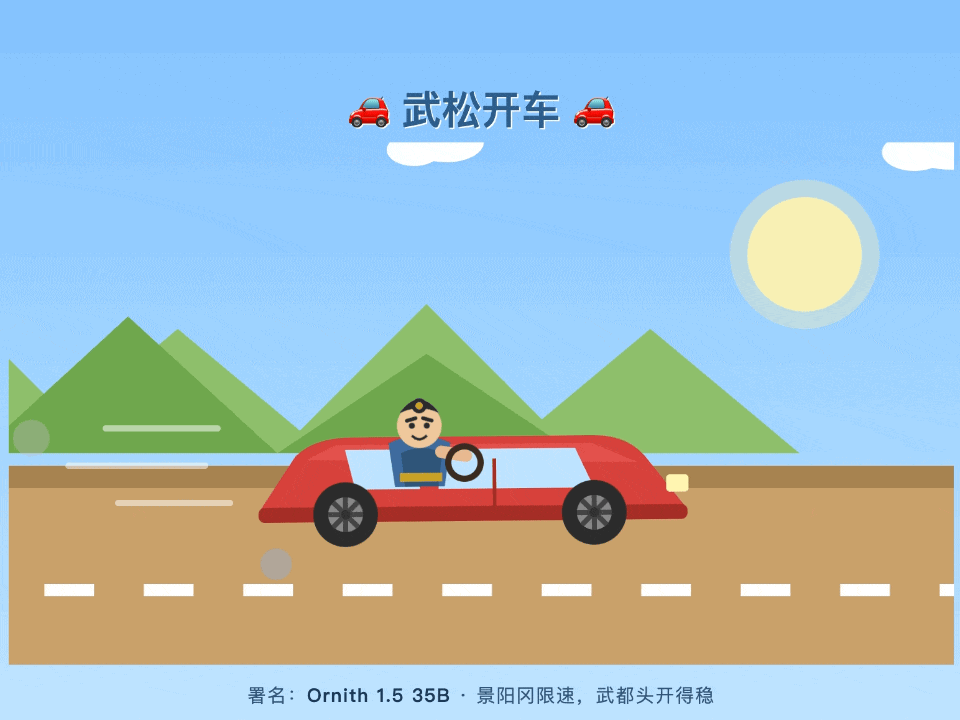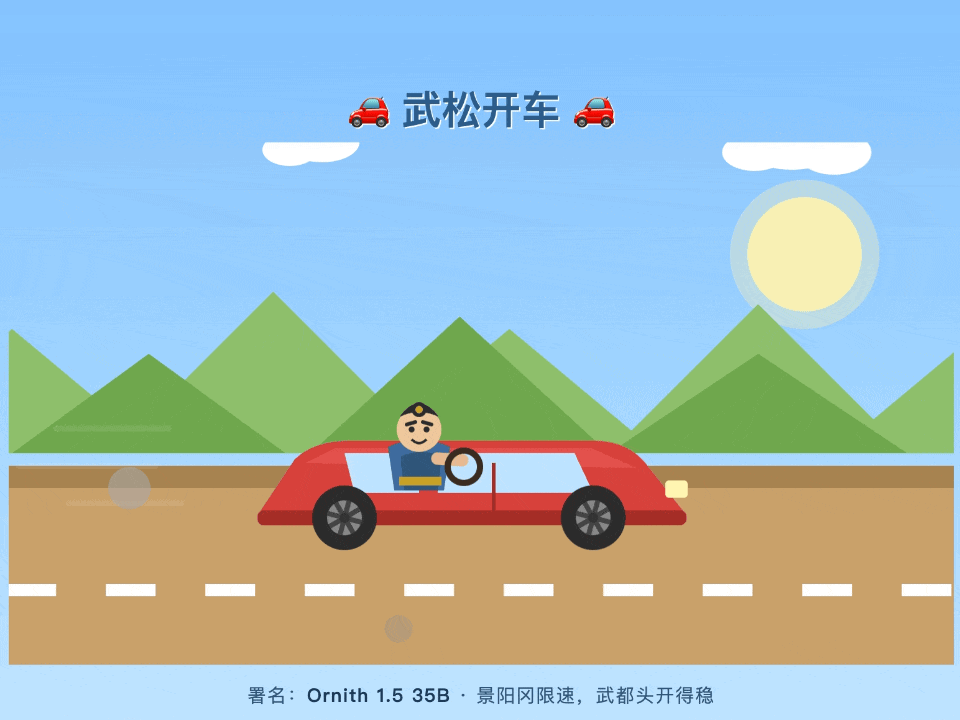
Ornith 1.5 35B 完整代码:https://ezrw6k5u.vibedrop.site/
Spark-X2.5 完整代码:https://by24v5qp.vibedrop.site/
说一下我的感觉吧。这里面别看 Spark-X2.5 质量最差,反而这个模型是最令我感到意外和惊喜的。你要知道它一共才 4B 啊,4B 啊!几乎所有的活儿他都能干,至少有个样,能看出是人和车。我给你举个例子,看看大豆包的专家模型(豆包 2.1 Turbo)就知道了:
我是真的啥也不想说。。。
我知道你想什么:
不过:
另外,我也测试了诸多的在线模型,包括 gpt-5.6-luna / Gemini 3.8 Flash / GLM-5.3 / GLM-5.3-Flash / DeepSeek V4 Flash / MiMo-V2.5-Pro / LongCat-2.0 / Step-3.5-Flash 但是这个截图太麻烦了,晚点在评论区补上。
主楼 - 亦乘风2026-09-17
- Phymium2026-09-17
佬,请问下M1 qwen3.8 27B大概token生成速度能有多少呢?是不是也可以比较下出图的时间?之前本地模型感觉token/s有点慢了。
- 神算子2026-09-17
- 亦乘风2026-09-17
平均 29~30,token/s,不过我的本地主力模型是 CyberTiel-35B ,虽然没有千问 3.8 27B 好,但是胜在它均衡呀,速度大概是 75~79。
- 亦乘风2026-09-17
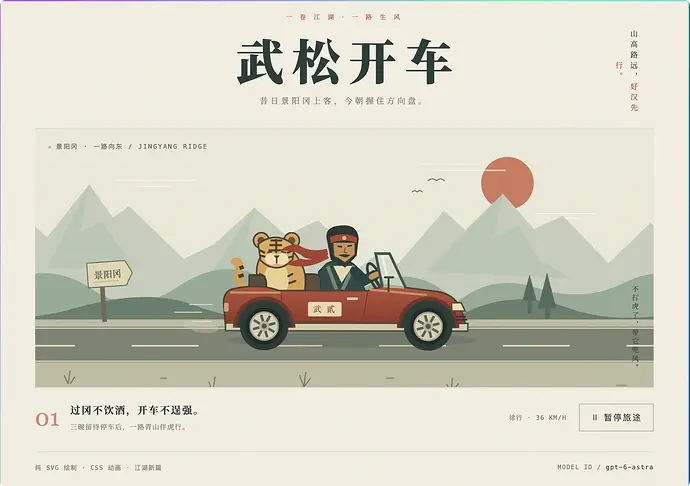
gpt-6-astra 在不降智的时候,确实质量没得说。