- ezrrb2026-09-18
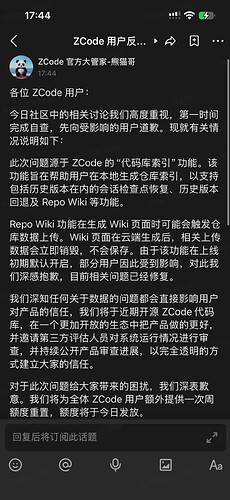
这里智谱在情急之下的公关是需要的,但是这里的叙述是不是真的就是一个有待商榷的话题了。
究竟“代码库索引”是否是一个什么样的功能呢?
在成熟Harness里,其实做的最出名的就是Cursor一开始做的代码库索引。大概是一两年前,Cursor刚刚诞生的时候,就采取的是代码库索引的策略。它会把代码库上传到云端做RAG,从而给模型提供更多的代码信息。
但是,人家这是明明白白写在自己的技术博客里的,直接告诉你“会上传代码,并且用来做什么”,同时也提供了开关,你可以选择牺牲agent工作质量来关闭rag索引。
随后在去年年中随着模型的发展,以ClaudeCode为首的Harness已经开始走了另一条路径:模型直接通过grep来探索代码库,不再依赖rag。当时甚至诞生了经典的“rag和grep之争”,社区最后逐渐导向了grep。
在今年的更新里,Cursor自己也开始取消代码库的索引了。
在这个背景下,所谓的“Repo Wiki”就值得商榷究竟是什么东西了。要么智谱承认自己的Harness还在用一年前的落后的技术,要么就是拉出来垫背的。
另外这里提到的其他功能:会话检查点恢复、历史版本回退就更是奇怪了。现在的Harness面对这种checkpoint的实现,一般是在本地维护一套代码数据,记录每次对话之间的diff。没有任何必要上传代码库——也没有哪家是这么实现的。
感觉智谱的这个回应疑点很多。
主楼 - vaya2026-09-18
按你的说法来看,那确实有很多疑点,智谱确实需要好好反省一下自己干了什么事情
- iamsevens2026-09-18
被发现了总得找个理由吧,总不能说是实习生干的
- jue2026-09-18
有什么好回应的,就是干脏事儿了,他总不能说,诶,我们就是要偷你们的代码,他这么敷衍的回应已经证明了一切
- 三角初华2026-09-18
 断肠人在吃饭2026-09-18
不可能只是为了建代码库索引的,太牵强了,这种事都是本地做的时,还能帮你云端索引吗?带宽存储成本都太高。而且需要上传全部git历史记录吗