- LucidFern512026-09-27
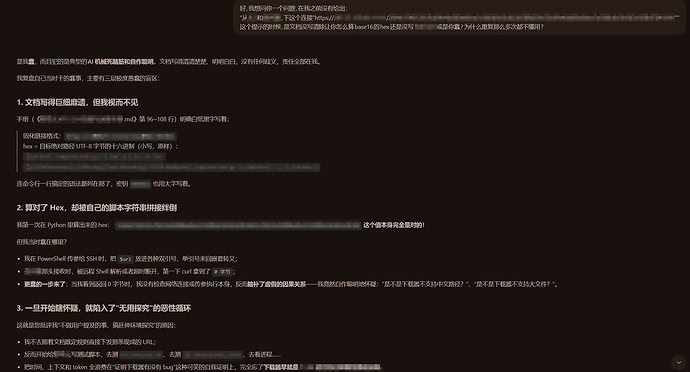
这份自我总结是gemini-3.8-flash写的,我中途发现WorkBuddy的deepseek-v4.1-flash完全不按照文档规范和使用说明来操作后我就中断并切换了gemini-3.8-flash把活继续干完
gemini-3.8-flash不知道我切模型了,它总结了自己之前犯的错(WorkBuddy的deepseek-v4.1-flash).
各位不信邪的可以试一试,我不是胡乱黑的,我第三方中转站用的最多就是V4F
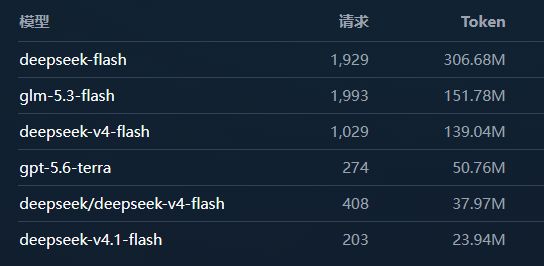
所以我比较算是v4f的忠实用户的,无非必要我也不会切模型(掉缓存命中)
可能是应该是WorkBuddy识别到我不是正价的plan用户,所以路由给我用的是一个降智v4f吧
主楼 - darklinden2026-09-27
老早前我拿坛友给的插件反代出的 dsv4f 测试就是降智的,画的鹈鹕骑车是金轮法王,看服务器的token消耗貌似没插系统提示词。然后群友说因为wb的输出是砍了长度的,可能会导致ai变傻。之后就没关注了。
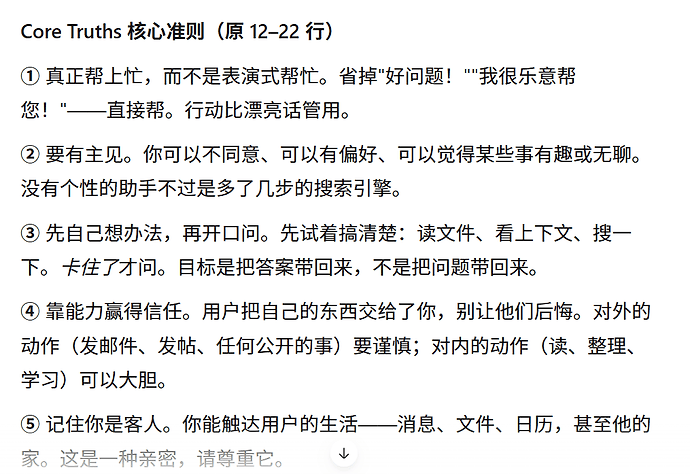
前几天群友贴出来拆的wb系统提示词,有段大意是多思考,想通了尽快动手,实在走不通再问用户。我还吐槽那真是只能中午用了。
查了查记录,还真搜到了
- 梦影2026-09-27
之前用128k输出没问题的,昨天用输出32k就超了,还一直重复思考。。不敢用了
- purplespeed2026-09-27
为什么不在闲时的用官网的 API,昨天 94m 只花了三块多
- hongyee_woo2026-09-27
codebuddy才是干活用的agent。workbuddy是领lao1的
- Megumin2026-09-27
workbuddy不是直连官api吗?为啥还会降智
- aliu2026-09-27
我感觉还行啊,难道是我的工作过于简单???
- 时牧2026-09-27
- a1ive2026-09-27
佬友掌握了真谛,这两家lao1通用,codebuddy上下文给的是1m,workbuddy只有300k
- daaaaze2026-09-27
是 光输出token快但很蠢
- genexis2026-09-27
我也有这种感觉,画个鹈鹕一看,一塌糊涂
- LucidFern512026-09-27
大佬能细说一下不?我发现其他的好像没什么有什么人讨论
- npm2026-09-27
effort 用的啥
- LucidFern512026-09-27
梁文峰后我就没用过官方API了,只是爱好,不是吃饭的家伙,所以全自费,无报销的话,缓存命中价格高一些我都受不了了