- 废品2026-09-29
纯讨论一下,公司机器显卡4090 24g,可以用20g左右(要留点显存其他软件用)。 因为是蹭公司的设备和电所以只聊聊本地的能力不考虑和api做性价比对比。
模型用的unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf。
主要想拿来辅助简单的编程agent,真的可以拿来干活了么? 至少要支持一个96k上下文的会话吧。
还有各种量化版本,各位佬推荐什么方案啊?
GSQ-RCOIQ3_S
UD-Q4_K_M
Swift 1.5
SwiftxGSQ-RCO
Flash-Next GGUF
Bonsai2-27B
QUASAR-QATNVFP4
Uncensored去审查版```
llama-server.exe ^
-m "Qwen3.8-27B-UD-Q4_K_M.gguf" ^
--host 127.0.0.1 ^
--port 8033 ^
-ngl 999 ^
-c 131072 ^
--flash-attn on ^
--cache-type-k q8_0 ^
--cache-type-v q8_0 ^
--spec-type draft-mtp ^
--spec-draft-n-max 2 ^
--parallel 1 ^
--jinja ^
--load-mode mlock ^
--alias qwen3.8-27b
```一句话两分半钟静态svg感觉这虽然没什么细节,但鸟和自行车大形状至少没什么问题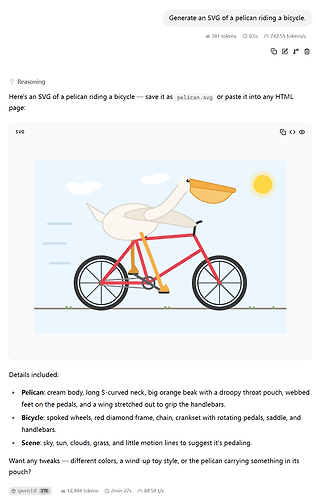 主楼
- YBFACC2026-09-29
个人理解: 除非想部署无审核的模型,个人机部署价值不如 api 订阅
- YBFACC2026-09-29
公司就申请配置呗,整个能干活的配置 ^-^
- RanboJames2026-09-29
能力还行,就是太太太太慢了!一个任务一上午,你发一句,它能工作几个小时那种!
- 废品2026-09-29
目前已经有这4090的机器,让我再申请更高配的那估计也申请不下来
- 废品2026-09-29
额这么慢么?我看这输出七八十tps还可以啊
- Eugene2026-09-29
prefill很慢,有公网的情况下是浪费时间
- RanboJames2026-09-29
不是输出慢,是思考得多,思考得久,我们内网部署的我基本是布置一个任务跑一上午 ^-^
- 炫彩小鱼干2026-09-29
分享一下关于部署 qwen27b 的最新成果【配置分享】 推荐一下我的方案,如果想省显存可以开q4kv,我个人感觉200k+上下文还是挺重要的(因为思考很长,一次任务基本就需要compact一次甚至几次)
- 废品2026-09-29
帖子里的svg数据大概是这样吧```
[34m0.48.998.158[0m [32mI [0mslot get_availabl: id 0 | task -1 | selected slot by LRU, t_last = -1
[34m0.48.998.900[0m [32mI [0mslot launch_slot_: id 0 | task 0 | processing task, is_child = 0
[34m0.52.539.348[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 257, tg = 84.57 t/s, tg_3s = 84.89 t/s
[34m0.55.540.250[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 503, tg = 83.28 t/s, tg_3s = 81.98 t/s
[34m0.58.568.307[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 748, tg = 82.49 t/s, tg_3s = 80.91 t/s
[34m1.01.581.137[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 1008, tg = 83.44 t/s, tg_3s = 86.30 t/s
[34m1.04.596.255[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 1252, tg = 82.93 t/s, tg_3s = 80.93 t/s
[34m1.07.599.301[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 1491, tg = 82.38 t/s, tg_3s = 79.59 t/s
[34m1.10.607.353[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 1730, tg = 81.96 t/s, tg_3s = 79.45 t/s
[34m1.13.617.543[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 1958, tg = 81.19 t/s, tg_3s = 75.74 t/s
[34m1.16.634.432[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 2227, tg = 82.07 t/s, tg_3s = 89.16 t/s
[34m1.19.642.029[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 2488, tg = 82.54 t/s, tg_3s = 86.78 t/s
[34m1.22.666.035[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 2748, tg = 82.86 t/s, tg_3s = 85.98 t/s
[34m1.25.670.108[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 2994, tg = 82.78 t/s, tg_3s = 81.89 t/s
[34m1.28.684.961[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 3250, tg = 82.94 t/s, tg_3s = 84.91 t/s
[34m1.31.693.442[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 3480, tg = 82.48 t/s, tg_3s = 76.45 t/s
[34m1.34.712.979[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 3727, tg = 82.43 t/s, tg_3s = 81.80 t/s
[34m1.37.734.318[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 3976, tg = 82.43 t/s, tg_3s = 82.41 t/s
[34m1.40.761.929[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 4247, tg = 82.85 t/s, tg_3s = 89.51 t/s
[34m1.43.782.274[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 4483, tg = 82.59 t/s, tg_3s = 78.14 t/s
[34m1.46.794.277[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 4719, tg = 82.36 t/s, tg_3s = 78.35 t/s
[34m1.49.799.825[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 4936, tg = 81.86 t/s, tg_3s = 72.20 t/s
[34m1.52.825.113[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 5177, tg = 81.75 t/s, tg_3s = 79.66 t/s
[34m1.55.844.613[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 5428, tg = 81.82 t/s, tg_3s = 83.13 t/s
[34m1.58.872.106[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 5655, tg = 81.52 t/s, tg_3s = 74.98 t/s
[34m2.01.875.986[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 5896, tg = 81.46 t/s, tg_3s = 80.23 t/s
[34m2.04.904.851[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 6168, tg = 81.80 t/s, tg_3s = 89.80 t/s
[34m2.07.934.444[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 6450, tg = 82.23 t/s, tg_3s = 93.08 t/s
[34m2.10.954.543[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 6696, tg = 82.21 t/s, tg_3s = 81.45 t/s
[34m2.13.969.676[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 6909, tg = 81.79 t/s, tg_3s = 70.64 t/s
[34m2.16.980.570[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 7141, tg = 81.63 t/s, tg_3s = 77.05 t/s
[34m2.19.989.887[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 7371, tg = 81.46 t/s, tg_3s = 76.43 t/s
[34m2.22.999.452[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 7577, tg = 81.04 t/s, tg_3s = 68.45 t/s
[34m2.26.020.863[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 7843, tg = 81.26 t/s, tg_3s = 88.04 t/s
[34m2.29.038.725[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 8094, tg = 81.31 t/s, tg_3s = 83.17 t/s
[34m2.32.047.701[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 8323, tg = 81.16 t/s, tg_3s = 76.11 t/s
[34m2.35.068.716[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 8577, tg = 81.25 t/s, tg_3s = 84.08 t/s
[34m2.38.083.146[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 8830, tg = 81.32 t/s, tg_3s = 83.93 t/s
[34m2.41.102.376[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 9080, tg = 81.36 t/s, tg_3s = 82.80 t/s
[34m2.44.120.437[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 9329, tg = 81.39 t/s, tg_3s = 82.50 t/s
[34m2.47.134.512[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 9617, tg = 81.75 t/s, tg_3s = 95.55 t/s
[34m2.50.147.280[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 9906, tg = 82.11 t/s, tg_3s = 95.93 t/s
[34m2.53.158.449[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 10193, tg = 82.43 t/s, tg_3s = 95.31 t/s
[34m2.56.180.145[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 10488, tg = 82.79 t/s, tg_3s = 97.63 t/s
[34m2.59.208.579[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 10785, tg = 83.15 t/s, tg_3s = 98.07 t/s
[34m3.02.210.317[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 11079, tg = 83.48 t/s, tg_3s = 97.94 t/s
[34m3.05.212.627[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 11370, tg = 83.78 t/s, tg_3s = 96.93 t/s
[34m3.08.226.430[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 11664, tg = 84.08 t/s, tg_3s = 97.55 t/s
[34m3.11.233.096[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 11954, tg = 84.34 t/s, tg_3s = 96.45 t/s
[34m3.14.243.108[0m [32mI [0mslot print_timing: id 0 | task 0 | n_gen = 12248, tg = 84.62 t/s, tg_3s = 97.67 t/s
[34m3.16.643.142[0m [32mI [0mslot print_timing: id 0 | task 0 | prompt eval time = 513.10 ms / 381 tokens ( 1.35 ms per token, 742.55 tokens per second)
[34m3.16.643.145[0m [32mI [0mslot print_timing: id 0 | task 0 | eval time = 147130.97 ms / 12444 tokens ( 11.82 ms per token, 84.57 tokens per second)
[34m3.16.643.151[0m [32mI [0mslot print_timing: id 0 | task 0 | total time = 147644.07 ms / 12825 tokens
[34m3.16.643.152[0m [32mI [0mslot print_timing: id 0 | task 0 | graphs reused = 4875
[34m3.16.643.156[0m [32mI [0mslot print_timing: id 0 | task 0 | draft acceptance = 0.76325 ( 7518 accepted / 9850 generated), mean len = 2.53
[34m3.16.643.209[0m [32mI [0mslot release: id 0 | task 0 | stop processing: n_tokens = 12824, truncated = 0 - 废品2026-09-29
要是晚上睡觉让它自己跑点任务是不是可以?
- 太阳之子2026-09-29
- 👑十万大山的山大王👑2026-09-29
如果没有特殊需求可以不考虑 uncensored 版本,用 unsloth 的量化版就可以 UD-Q4_K_M。如果需要破限版,可以去 HF 下载 orcarouter 做的破限版,至于为什么我推荐他的破限版,可以看这篇文章 Qwen3.8-27B Abliteration Benchmarks: 12 Variants Compared | Abliterlitics
- 天痴2026-09-29
这配置不如拿来生图生视频,网上量大管饱的大模型都甩这玩意几条街,别想不开
- 炫彩小鱼干2026-09-29
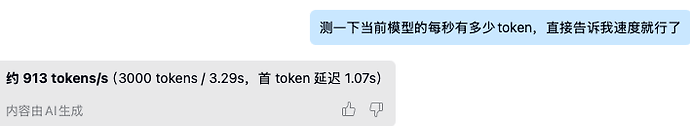
请问这个速度是哪里的服务?900tps 太爽了吧
- 太阳之子2026-09-29
之前活动白嫖的几批cerebras账号,一直没用完 ^-^
- 𝕹𝖔𝖙𝖍𝖎𝖓𝖌_𝖎𝖘_𝕿𝖗𝖚𝖊._𝕰𝖛𝖊2026-09-29
确实。不思考的话差点意思,思考的话,稍微复杂点的问题就想半天。
- Xer562026-09-29
和速度没关系,是 token 效率不够,雷霆大思考,同样问题,qwen3.8-27b 可能需要几亿 token,而其他模型只需要几百万 token,你生成速度就算是几百 tokens/s,也还是慢。
- XZiar2026-09-29
如果不是为了cpu offload或者老显卡限制,不太建议用原版llamacpp,性能不太行。
可以考虑exllamav3跑exl3量化的,有不同大小可选,同bpw下比QxK效果更好,速度也更快,不过只支持chat completion的api。
- 废品2026-09-29
你这为什么能到3000/3.3s啊?比我的快好多