- Eason_Yan2026-09-30
佬们,现在大模型的视觉理解都已经这么强了,为什么我让它帮忙去做一些目标检测任务的标注,却弄得非常差?为什么会出现这种情况呢?这个地方有点不太理解。
主楼 - agi_is_coming2026-09-30
- leonvxe2026-09-30
你的视觉能力强的结论是怎么来的?
- 宫野志保2026-09-30
常见的目标是可以的,不过要注意不同的模型输出图片的坐标不太一样,有的是绝对坐标,有的是归一化到1000的
- bobo13142026-09-30
你用它来做啥了,yolo?
- mounttai2026-09-30
能不能让大模型操纵检测模型,RSI了
- Crazy-092026-09-30
虽然说有一个新闻是Ai解决人类无法解决的问题,但是还不成熟,你没办法让Ai去做没有资料的东西。
就算写代码,你看看github没有的项目,叫Ai写出来的代码逻辑,跑都跑不顺,测试都是自己编的,你说清楚逻辑的情况都写不出来
- Eason_Yan2026-09-30
是的,做YOLO,但我觉得一些简单的物品应该是比较好识别的,就是不知道为什么做出来效果不好。
- Eason_Yan2026-09-30
好的,谢谢大佬。我去看看
- Eason_Yan2026-09-30
是的,我觉得输入到大模型token化了之后,应该是丢失了绝对坐标。
- Sky3902026-09-30
标注任务就是很难绷,我前两天让 ds 和 glm 标数据集给我整破防了,最后还是手动标的。
- neteroster2026-09-30
- neteroster2026-09-30
我举个例子 有人测这个

X (formerly Twitter) – 5 Sep 26
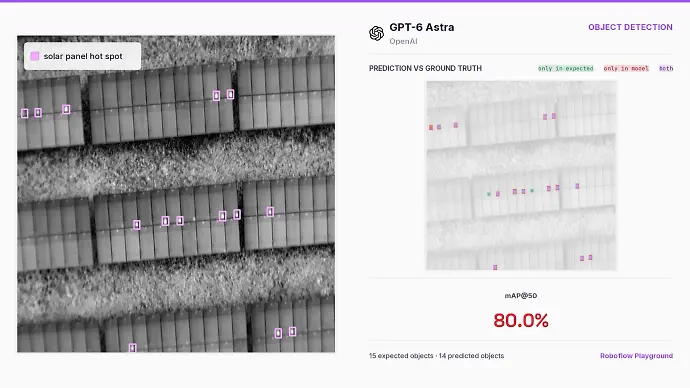
X 上的 SkalskiP (@skalskip92)
Gemini dethroned
GPT-6 Astra is the best "vision" model I've seen
- notices tiny details
- draws conclusions
- produces precise and tight boxes
- sees and reads text in different contexts
- knows a lot about a lot
- fast
- expensive
↓ GPT-6 Astra...
- DeepSuck-深度求嗦2026-09-30
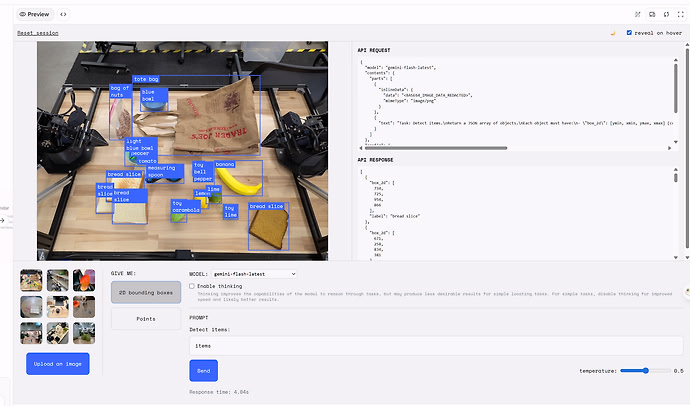

Google AI for Developers
图片理解 | Gemini API | Google AI for Developers
开始在 Gemini API 中使用 Gemini 的多模态功能构建
谷歌gemini这个可以 你去试试
在aistudio的gallery搜 Robotics Spatial Understanding有的体验