- V_Arrow2026-10-01
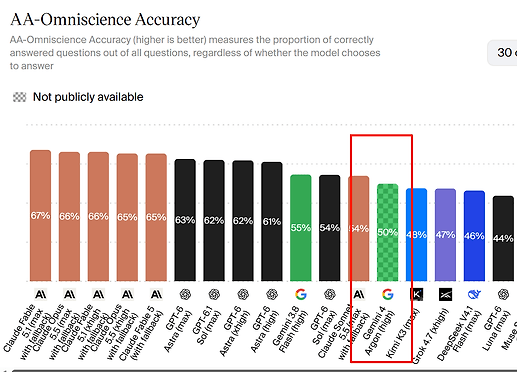
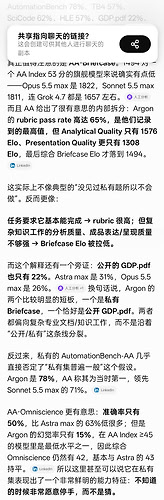
试着让GPT分析了一下Argon的AA index各个子项的得分,本来我是问是否出现了公开测试集核弹爆炸,私有测试集拉胯的情况,GPT分析以后说是没有明显证据,反而给出了这个结论:```
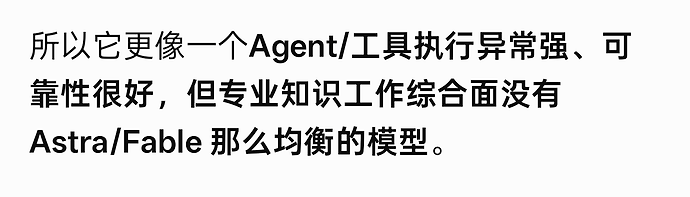
具体交给他的任务会完成得很好,但是复杂任务的分析的世界知识表现不行。
```搞了半天还是个大号Flash啊,没记错的话3.5 Flash定价好像就是输出接近9USD了吧,倒是和Argon差不多。^-^GPT详细结论
 主楼
- 亓水2026-10-01
- windgo2026-10-01
这个跟之前披着3.8皮测试的4pro是一个模型吗
- 板栗君2026-10-01
啊喂,这都还没开始用上呢,从跑分逆推?… 有点离谱哦
- V_Arrow2026-10-01
毕竟现在没有其它测试数据,就当图一乐吧
- 大雨落江面2026-10-01
无敌了,还有这样蹭热度的。这跟AI判刑有什么区别。
- Hifumi_Mizuhara2026-10-01
大砍知识量但是Text arena第一吗,那咕咕嘎嘎很有黑科技了^-^
- V_Arrow2026-10-01
从另一个角度,连容易拿分的跑分都表现不佳,真实性能确实容易怀疑^-^
- V_Arrow2026-10-01
对我来说只要文笔能稳住我依旧愿意用
- 板栗君2026-10-01
楼上所说的Text arena就不是一个容易拿高分的 ^-^ 跃迁式增长了,还是值得期待的
- quina2026-10-01
那skill表现能比较好?那其实利好外接方法,没实测不好下定论啊XD
- liuliu2026-10-01
咱是预期是好用的,难得有这么慷慨的平台。
- V_Arrow2026-10-01
希望向公众开放后能打脸吧,依稀记得当年Claude3好像就是跑分没赢过体验没输过
- V_Arrow2026-10-01
至少根据哈基米的前科来看,有必要提前降低预期。当时3.7还是3.8,DeepSwe等旧测试集直接对标Sol,结果还不是美国豆包。
- 大雨落江面2026-10-01
谷歌吹牛逼是必然的,我是说用gpt测评纯搞笑。
- 丰川祥子2026-10-01
根据提示词的不同,或许GPT会给出完全相反的结论也说不定
- ishtar2026-10-01
- SpaceQ2026-10-01
不是吧,gemini一个还值得 称道的就是它的世界知识量和智商了,把这个都砍了不是自废武功吗。还是说看到AO在coding和agent方面那么风光之后,坐不住了,路线也要往这方面倾斜?
- 哈比2026-10-01
不是哥们,咱都还没用呢就开始分析上了。而且盲目相信一个 AI 的判断也不好吧?而且世界知识库这一块我觉得压根就不可能砍,因为这相当于自废武功了。
- scp35002026-10-01