- LONGSHENYIZU2026-04-20
这不是一篇"AI 写代码好厉害"的软文。我想分享一个学药的大学生如何在凌晨、对着终端屏幕、用一个叫
/loop的命令,让 AI 在自己睡觉的时候继续写代码的记录与复盘。写在前面
我参加的是 2026 年第 19 届中国大学生计算机设计大赛,作品是 NetPharm —— 一个网络药理学知识分享平台。
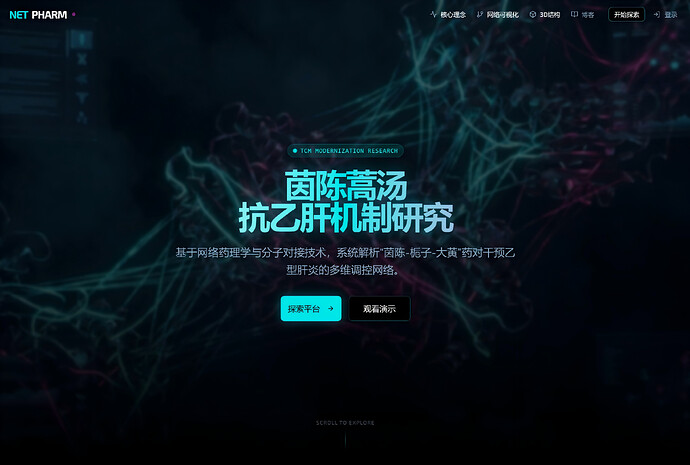
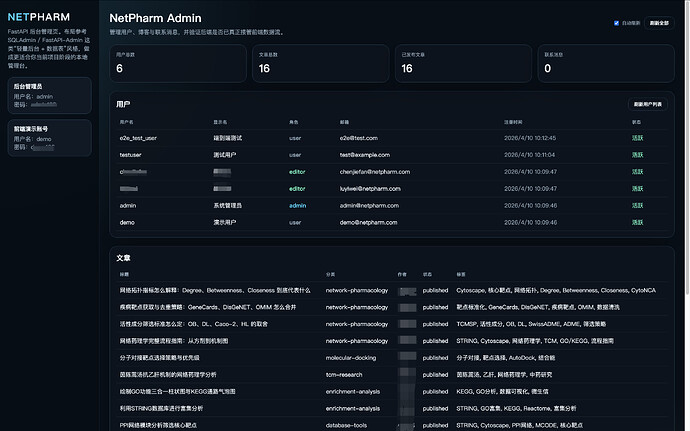
这个项目前端 45 个源文件约 7800 行代码,后端 48 个 Python 文件约 3500+ 行,涵盖 6 种交互式数据可视化(D3.js / ECharts / Three.js / Canvas)、16 篇专业博客、完整的用户认证系统、管理后台。
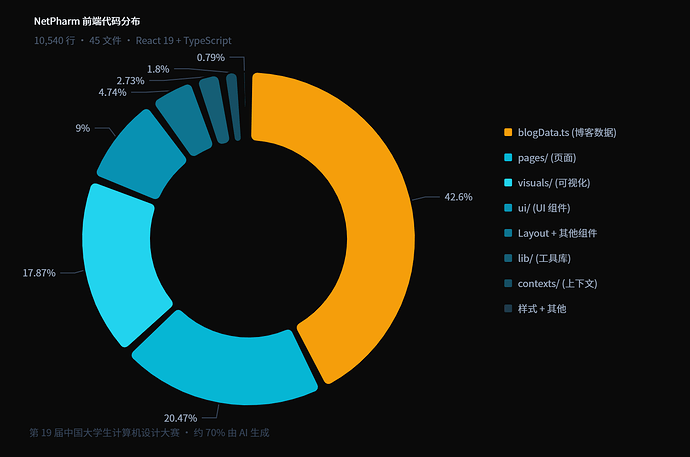
其中大约 70% 的代码,是 GLM-5.1在凌晨自动生成的。
我想聊的是:怎么拆任务、怎么写 prompt、怎么用
/loop让 AI 在你睡觉的时候持续输出,以及中间翻了多少次车。一、项目是什么:给不懂药理学的开发者看的介绍
网络药理学是中医药现代化的一个研究方向:用计算方法分析中药复方(比如"茵陈蒿汤")中的有效成分如何作用于人体靶点蛋白,从而解释"这个药为什么管用"。
我们的平台以我的大创"茵陈蒿汤抗乙肝机制研究"为核心案例做了延伸,做了这些事:
- 6 种交互式可视化:分子互作网络力导向图(D3)、药物筛选流程图(ECharts)、粒子流图(Canvas)、3D 分子对接(Three.js)、热图/气泡图(ECharts)、3D Hero 分子动画
- 知识博客系统:16 篇网络药理学专业文章,支持分类、标签、全文搜索
- 全栈认证:注册/登录/JWT 鉴权/个人中心
- 管理后台:用户管理、文章管理、联系消息管理(值得一提的是我用的python写的后端,更方便未来接入AI/ML)
- 响应式设计:桌面/平板/移动端全适配
技术栈:React 19 + TypeScript + Vite 7 + Tailwind CSS v4 + FastAPI + SQLAlchemy 2.x
二、先说方法论:拆任务
很多人刚vibe coding的时候踩过一个坑:一开始给 AI 发"帮我写一个网络药理学平台",拿到的东西没法用。跟给人类同事甩一句"做个网站出来"差不多。
后来我学乖了,开始拆任务。拆到什么程度?大概是一个 15 分钟内能说清楚、能验证的小目标。
我的拆法分三步:```
比赛要求 → 功能清单 → 独立模块 → 可执行的 prompt
```第一步,从比赛要求推导功能清单。软件应用与开发类的评分标准我过了一遍,列出来必须有的东西:- 信息展示(研究背景、方法论)
- 交互式可视化(至少 3 种,越多越加分)
- 用户系统(注册、登录、个人中心)
- 内容管理(博客/教程)
- 后台管理
- 联系方式
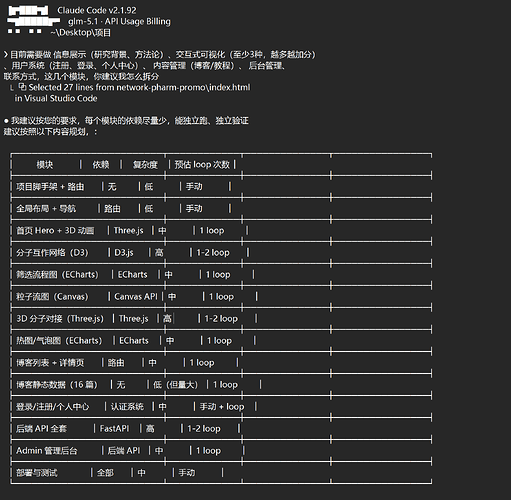
第二步,按技术边界拆成独立模块。我借助GLM-5.1用一张表来规划:
模块 |
依赖 |
复杂度 |
预估 loop 次数 |项目脚手架 + 路由 |
无 |
低 |
手动 |全局布局 + 导航 |
路由 |
低 |
手动 |首页 Hero + 3D 动画 |
Three.js |
中 |
1 loop |分子互作网络(D3) |
D3.js |
高 |
1-2 loop |筛选流程图(ECharts) |
ECharts |
中 |
1 loop |粒子流图(Canvas) |
Canvas API |
中 |
1 loop |3D 分子对接(Three.js) |
Three.js |
高 |
1-2 loop |热图/气泡图(ECharts) |
ECharts |
中 |
1 loop |博客列表 + 详情页 |
路由 |
中 |
1 loop |博客静态数据(16 篇) |
无 |
低(但量大) |
1 loop |登录/注册/个人中心 |
认证系统 |
中 |
手动 + loop |后端 API 全套 |
FastAPI |
高 |
1-2 loop |Admin 管理后台 |
后端 API |
中 |
1 loop |部署与测试 |
全部 |
中 |
手动 |拆分任务的原则很简单:每个模块的依赖尽量少,能独立跑、独立验证。
第三步,每个模块再拆成具体的 prompt。比如"分子互作网络"这个模块,我不会直接说"帮我写 MolecularNetwork 组件"。拆法如下:```
任务 1: 创建 src/components/visuals/MolecularNetwork.tsx
- 接收 props: { nodes: Node[], links: Link[], width, height }
- 使用 D3 forceSimulation 实现力导向布局
- 节点按类型用不同颜色(药物=青色,靶点=品红)
- 拖拽交互、缩放、hover 显示详情
- 暗色主题,节点发光效果任务 2: 创建 mock 数据 src/data/molecularData.ts
- 茵陈蒿汤的 15 个活性成分
- 对应的 20 个靶点蛋白
- 成分-靶点互作关系任务 3: 集成到 Home.tsx 首页
- 在首页"分子互作网络"section 中引入 MolecularNetwork 组件
- 响应式尺寸(桌面 100%,移动端全宽)
- 加载状态、错误边界
``每个任务大约 15-30 分钟的 AI 工作量,刚好是一个/loop` 的合适粒度。由多个
/loop合并起来的,有人工加易修改,最后可以得到类似这种效果(后文有提多个loop串在一起的这种方法 )2.2 怎么判断拆得够不够细
后来我在一篇文章里看到一个说法,觉得说得很好:拆任务的终极目标不是"看起来细",而是让每个子任务满足三个条件——可验证、可回滚、可重启
翻译成大白话就是三个判断题:
- 我能不能写出一句话的 Done?(最好机器能验证)
- 坏了能不能在 5 分钟内回滚到稳定态?
- 如果 AI 上下文清空了,只看仓库代码和这张任务描述,能不能继续?
三个问题里任意一个答"不能",就继续拆。我踩的几次坑,事后回看都是拆得不够细导致的。
2.3 任务拆分的"画布法":不只列清单,画依赖图
光有一张任务清单还不够。当任务之间有依赖关系时(比如"组件开发"依赖"数据结构定义",“集成到页面"依赖"组件开发”),一张平铺的列表会让人(和 AI)看不清执行顺序。
我后来用一种"画布"的方式来组织任务。本质上是一张表,但每个任务卡片上都标注了三个关键信息:```
┌─────────────────────────────────────────────────────────┐
│ Task 05: 分子互作网络组件 (MolecularNetwork.tsx) │
├─────────────────────────────────────────────────────────┤
│ 依赖: Task 03 (数据模型定义) │
│ 产出: src/components/visuals/MolecularNetwork.tsx │
│ 验证: pnpm type-check 通过 + 可独立渲染 │
│ 粒度: ~20 分钟 AI 工作量 │
│ 上下文: 需要 molecularData.ts 的类型定义作为输入 │
└─────────────────────────────────────────────────────────┘
```画完这张画布之后,执行顺序自然就出来了——没有依赖的任务可以并行(用多个 loop),有依赖的任务串行(接力式执行)。而且每个任务的"验证标准"和"上下文需求"都是提前写好的,不需要等到 loop 启动时才临时想。
这样做还有一个好处:如果某个 loop 翻车了(比如 AI 写了一堆垃圾代码),我可以精确地知道要回退到哪个 checkpoint,重新执行哪几个任务卡片,而不是像无头苍蝇一样从头来。
三、
/loop是什么,以及我怎么用的3.1
/loop简单介绍我在2026.4.9~2026.4.12这几天用的是 Claude Code v2.1.92
/loop的机制:你给 AI 一个任务描述,它会按照你设定的时间间隔,反复把这个 prompt 重新注入到当前会话中。AI 每次被触发时都能看到之前的完整对话历史,所以它能"接着上次干"。但它并没有内建的"检查→修错"逻辑。AI 是否会自我检查、是否会修复错误,完全取决于你在 prompt 里怎么写。它本质上是 session 内注册了一个定时任务(底层用 cron 调度),绑定当前会话,recurring 任务 7 天后自动过期。关掉终端、电脑休眠都会导致 loop 立即消失——没有持久化。和普通的"对话式编程"最大的区别是:
- 普通对话:你说一句,AI 回一句,你说下一句
- loop 模式:你说一次任务目标,AI 自己循环跑,你可以去睡觉
3.2 我的使用模式:混合策略
我的策略是"重活用按照上文细致规划后用 loop,细活手动来做或者探明问题之后直接叫AI改":
任务类型 |
策略 |
原因 |脚手架 + 配环境 |
手动为主 |
频繁决策,AI 容易配错 |单个可视化组件 |
loop |
目标清晰、可验证 |博客内容挂载(16 篇) |
loop |
量大但模式统一 |后端 API 全套 |
loop |
API 契约已明确定义 |样式微调、交互细节 |
手动 |
需要审美判断 |测试补写 |
loop |
模式化工作 |部署配置 |
手动 |
涉及密钥和环境差异 |3.3 一个典型的深夜 loop 流程
这是我最常用的工作流,经常发生在某个凌晨 00:00:```
23:30 看了一遍比赛要求(prd),梳理了明天要完成的模块
23:45 写好了 prompt,确认了目标
00:00 启动 /loop,内容大概是:
"请完成 MolecularNetwork.tsx 组件的开发。
要求:
1. 使用 D3.js forceSimulation
2. 支持 drag / zoom / hover
3. 暗色主题,节点发光效果
4. 确保通过 type-check 和 lint
完成后运行 pnpm type-check 验证"00:02 看着 AI 开始输出了第一版代码
00:05 确认 大致的方向没问题,放着笔记本去睡觉
``第二天早上 7:00 醒来:``
07:00 打开终端看结果
情况A:组件写完了,type-check 通过 → 人工审查代码质量
情况B:type-check 失败了 → 看错误日志,手动修复或再起一个 loop
情况C:AI 在某个地方卡住了 → 分析原因,调整 prompt 重新来
```说白了就是"人睡觉,AI 写代码"。但别误会,这不是每次都能成功的“魔法”。前面拆任务、写 prompt 花的时间才是大头。3.4 让 loop 收敛的关键:把"验收"交给机器
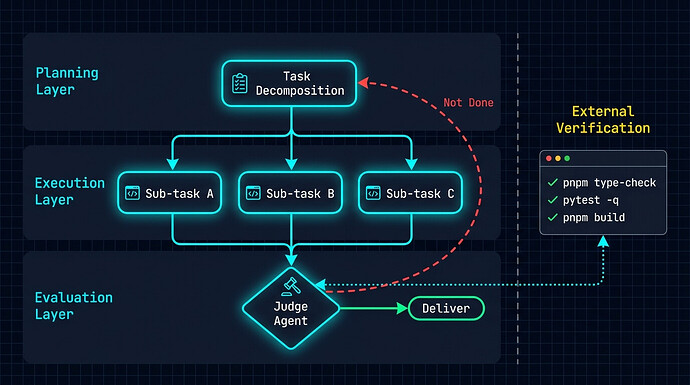
Cursor 在一篇关于长时间自主编码的文章里提到一个概念:每轮执行最后,需要一个 judge agent 来判定任务是否完成。Simon Willison 在引用这篇文章时补充说,当项目有强测试套件(conformance suites)时,AI 自主编码的成功率会大幅上升。
映射到我自己的场景:我睡觉的时候没法当 judge,所以必须把验收标准"外部化"成机器能跑的命令:
-
pnpm type-check(类型安全)-
pnpm lint(代码规范)-
pytest -q(后端逻辑正确性)-
pnpm test(前端逻辑正确性)没有自动化验收的 loop,本质上是随机游走,还是老虎机。有自动化验收的 loop,才会迭代逼近。这是我平时翻车翻多了之后才真正理解的。
3.5 多个 loop 串联:把长跑变成接力
前面说的都是"一个 loop 完成一个子任务"。但实际开发中,一个完整的功能模块往往需要好几个 loop 配合才能跑通。比如分子互作网络这个功能,光一个
MolecularNetwork.tsx组件不够,还得有 mock 数据、集成到页面、样式调优——这不是一个 loop 能搞定的。我摸索出来的一套方法是"接力式串联"。核心思路是:每个 loop 只负责一个明确的交付物,loop 和 loop 之间通过文件系统传递状态,而不是靠对话上下文。
具体怎么做:
第一步,把功能拆成有依赖关系的 loop 序列。 以分子互作网络为例:
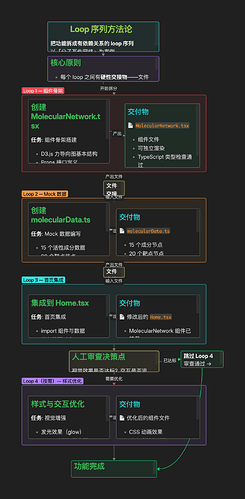 ```
Loop 1: 创建 MolecularNetwork.tsx 组件骨架
交付物: 组件文件,可独立渲染,type-check 通过
↓ 产出文件,作为 Loop 2 的输入Loop 2: 创建 molecularData.ts mock 数据
交付物: 数据文件,15 个成分 + 20 个靶点 + 互作关系
↓ 产出文件,作为 Loop 3 的输入Loop 3: 将组件集成到 Home.tsx 首页
交付物: 首页包含该组件,响应式布局正确
↓ 人工审查,决定是否需要 Loop 4Loop 4(按需): 样式优化和交互细节调整
交付物: 发光效果、hover 动画、移动端适配
```每个 loop 之间有一个硬性交接物——文件。前一个 loop 产出的文件就是后一个 loop 的输入,不需要任何对话历史。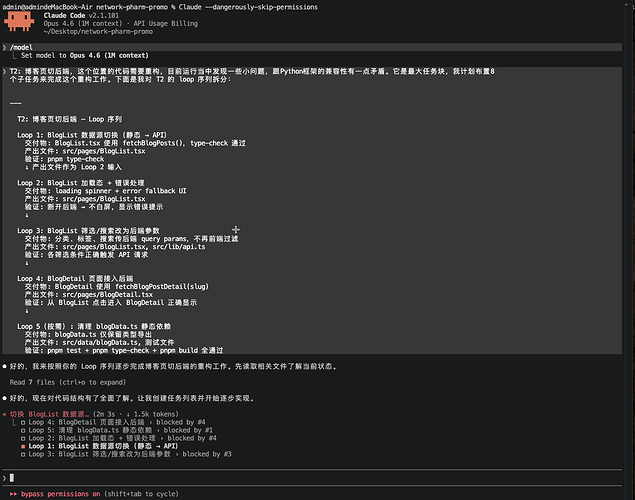
第二步,给每个 loop 写相对独立的 prompt,不依赖前一轮的对话。 这意味着 prompt 里要包含足够的上下文:项目路径、技术栈约束、依赖文件的位置。好处是,即使上一个 loop 的对话上下文已经清空了,新 loop 也能从仓库代码里读出它需要的一切。
第三步,用"进度文件"做跨 loop 的记忆。 我会在
docs/AI_PROGRESS.md里记录每个 loop 的状态:做了什么、跳过了什么、下一步是什么。新 loop 启动时先读这个文件,就能接上之前的进度。第四步,每完成一个 loop 做 git commit"。如果 Loop 3 发现 Loop 2 的数据结构不对,可以快速回退到 Loop 2 结束时的状态,修完再重来,不用从头开始。
0din.ai 把这种方法总结为无人值守 AI 编程的"三支柱"之一——Context(上下文管理)。Zach Wills 在管理 20 个并行 agent 的经验中也强调:长时间运行的 agent 是 bug,不是 feature;它们会漂移、压缩记忆、忘初衷。解决方案就是把大任务拆成小段,用文件和 git 做记忆载体,一段一段接力。
这套方法的实际效果:由多个 loop 串联执行,中间穿插人工审查和微调,最终可以得到一个完整的功能模块。
一个容易忽略的细节:loop 之间的人工介入。 不是每个 loop 结束后立刻启动下一个。我的做法是,每个 loop 完成后花 5-10 分钟做人工审查——看代码质量、看接口是否对得上、看有没有明显的方向偏差。发现问题就手动修,或者调整下一个 loop 的 prompt 再启动。纯串联不审查,错误会逐级放大。
3.6
/loop命令实操:不只是"说一句就走"前面讲了怎么用
/loop,但省略了一个关键细节:/loop命令本身有参数,选择不同的参数会直接影响你一晚上的产出质量。/loop的基本语法是:```
/loop [间隔] [任务描述]
``比如:``
/loop 5m 完成后端用户模块的 JWT 认证实现
/loop 10m 修复当前分支的所有类型错误
/loop 15m 创建 16 篇博客的静态数据文件
```几个关键细节:不写间隔时:默认 10 分钟。此时进入"动态自调步模式"(dynamic pacing),AI 自己判断什么时候该回来检查,而不是固定时间触发。
写了间隔时:按固定 cron 调度触发。支持
s(秒)、m(分钟)、h(小时)、d(天)作单位。非标准间隔(比如7m)会被自动取整到最近的分钟。触发时机:loop 在 AI 空闲时才触发(between turns),不会打断正在进行的回复。如果 AI 正忙,排队的 prompt 会等 AI 完成后再注入。
间隔怎么选? 这不是随便选的。我后来总结出一条经验法则:
任务类型 |
推荐间隔 |
原因 |组件开发(有 type-check) |
3-5 分钟 |
编译快,反馈及时 |后端 API 开发(有 pytest) |
5-10 分钟 |
测试启动有开销 |内容生成(16 篇博客) |
10-15 分钟 |
单篇生成+校验需要时间 |Bug 修复(反复跑测试) |
3-5 分钟 |
需要快速迭代 |全量构建检查 |
10-15 分钟 |pnpm build本身就要几十秒 |核心原则:间隔要给 AI 留够"一轮完整执行"的时间。 如果 type-check 要 30 秒,AI 修一个错误要 1-2 分钟,那你设 1 分钟的间隔太短了。虽然 loop 不会并发执行(AI 忙的时候 prompt 会排队等),但间隔太短会导致 prompt 堆积、上下文膨胀——AI 还没处理完上一轮,下一轮又来了,对话历史快速增长,反而加速上下文溢出。
另外,
/loop是 session 绑定的——关掉终端、断网、电脑休眠都会打断它。所以"深夜挂机"的前提是:终端窗口不能关,电脑不能休眠。我一般会把 Mac 的"防止自动进入睡眠"打开,或者用caffeinate命令防止休眠。3.7 离人状态的工程化:让 AI 在你睡觉时可靠地跑
"人睡觉,AI 写代码"听起来很美好,但实际操作中有一个核心问题:你怎么保证 AI 不会在你睡着之后跑偏?
答案是:现在的你/我都保证不了。但你可以通过工程化手段把跑偏的概率降到最低。我后来沉淀了一套"睡前检查清单"和"醒后验收流程"。
睡前检查清单(启动 loop 之前)
这个清单我每次启动 loop 之前都会过一遍,大概花 5 分钟:```
□ 1. 当前分支是干净的(没有未提交的改动)
→ 如果有,先 commit 或 stash,确保回退点明确□ 2. 所有测试是绿的(pnpm test / pytest -q 全通过)
→ 如果不是绿的,先修到全绿再启动 loop
→ 从一个"全绿"的状态出发,loop 翻车时才能清晰定位□ 3. prompt 里的目标只有 ONE 个
→ "完成 MolecularNetwork 组件" ✓
→ "完成组件 + 写测试 + 更新文档 + 调样式" ✗(目标太多)□ 4. prompt 里写了明确的验证命令
→ "完成后运行 pnpm type-check"
→ 如果没写,AI 可能"觉得做完了"但其实没验证□ 5. prompt 里写了失败时的行为
→ "如果 3 轮内无法修复,把当前进度写入 docs/AI_PROGRESS.md 然后停止"
→ 防止 AI 在错误方向上无限重试□ 6. CLAUDE.md 是最新的
→ 如果最近改了技术栈或代码规范,确保 CLAUDE.md 已更新
→ loop 启动后 AI 第一件事就是读 CLAUDE.md□ 7. 检查电脑不会自动休眠
→ macOS: 系统设置 → 电池 → 选项 → 防止自动进入睡眠
→ 或终端运行: caffeinate -d &
```这 7 步看着繁琐,但熟练之后 3-5 分钟就能过完。关键是第 1、2、6 步——它们确保了"出发点是正确的"。从错误的状态出发,loop 跑得越久,离目标越远。醒后验收流程(起床之后)```
第一步:看终端
→ loop 还在跑吗?还是已经停了?
→ 如果停了,是正常结束(输出了 COMPLETE)还是异常中断?第二步:看 git log
→ loop 期间有没有新 commit?
→ commit 之间是否有明显的方向偏移?(看 commit message)第三步:跑一遍验证
→ pnpm test && pnpm type-check && pnpm build
→ cd backend && pytest -q第四步:看代码质量(不是看能不能跑过检查)
→ 有没有 1000 行的巨型文件?
→ 有没有不该引入的新依赖?
→ 命名是否一致?
→ 代码结构和你在 CLAUDE.md 里定义的架构是否吻合?第五步:决策
→ 质量OK → 继续下一个 loop
→ 有小问题 → 手动修,或调整 prompt 再 loop
→ 方向偏了 → git reset 到 loop 开始前的 checkpoint,重写 prompt
```第五步是最重要的。Zach Wills 有一条建议我后来严格执行了:一旦走偏,立刻 kill + 更好的指令重跑,不要试图在错误方向上修修补补。 "修修补补"是最慢的路!!3.8 状态规范化:让 AI 不需要"回忆"就能继续
这里要讲一个很多人忽略的问题:在白板的状态下AI 没有长期记忆。
在不用任何插件的情况下,当你关掉一个终端会话,AI 在那个会话里积累的所有上下文(“我们讨论了什么”、“你偏好什么风格”、“之前尝试了什么失败了”)全部消失。新会话的 AI 是一个全新的实例,它唯一能获取的信息是:仓库代码 + 配置文件。
这意味着,如果你想让 AI 在多个 loop 之间保持一致性,必须把"状态"持久化到文件里。要么用一些记忆类的插件,但我个人更喜欢用四层状态管理:
第一层:CLAUDE.md —— 项目的"宪法"
/init 的命令生成的 CLAUDE.md 是 AI 每次打开项目时第一个读的文件。它定义了项目的所有硬性约束:```
CLAUDE.md
项目概述
NetPharm — 网络药理学知识分享平台...
常用命令
pnpm dev / pnpm build / pnpm test / pytest -q ...
技术栈
React 19 + TypeScript + Vite 7 + Tailwind CSS v4 + FastAPI + SQLAlchemy 2.x
架构
分层结构:Routes → Services → Repositories → Models
统一响应格式: {success: bool, data: T, message: str}关键约定
- 路径别名: @/ → ./src/
- 颜色系统: oklch 色彩空间
- 路由: hash 模式
- 组件约定: shadcn/ui 组件不要手动修改
已验证通过的状态
- pnpm test → 29/29 passing
- pytest -q → 25 passed
尚未完成的工作
1. 博客页切后端
2. Token 刷新机制
3. ...
```这份文件有多重要?我举一个例子:后端一次 loop 拉通成功,很大程度上是因为你提示词的约束很好或者 CLAUDE.md 里已经写清楚了"分层架构"、“统一响应格式”、“技术栈版本”。AI 不需要猜我要什么风格的后端,它照着"合同"执行就行。(GLM-5.1的指令遵从真的不赖)写 CLAUDE.md 的几个原则:
- 尽量只写"不变的东西"(技术栈、架构、约定、命令),不要写"状态"(做了什么、做到哪了)
- 每次技术决策变更后立刻更新(比如从 Node.js 换成 FastAPI)
- 在可以描述清楚的状况下,越具体越好——"使用 oklch 色彩空间"比"使用暗色主题"有用得多
第二层:进度文件 —— loop 之间的"交接单"
CLAUDE.md 是"静态宪法",进度文件是"动态状态"。我用
docs/AI_PROGRESS.md来记录每个 loop 的执行情况:```AI Progress
2026-04-10 Loop Session
Loop 1: MolecularNetwork 组件 ✅
- 产出: src/components/visuals/MolecularNetwork.tsx
- 验证: pnpm type-check 通过
- 跳过: 没加发光效果(下个 loop 补)
Loop 2: molecularData.ts ✅
- 产出: src/data/molecularData.ts
- 包含: 15 个活性成分 + 20 个靶点 + 互作关系
Loop 3: 集成到 Home.tsx ❌ BLOCKED
- 问题: 组件 props 类型不匹配,MolecularNetwork 期望的 Node 类型
和 molecularData.ts 导出的类型不一致
- 下一步: 先统一类型定义,再集成
```新 loop 启动时,第一件事就是读这个文件。AI 看到上一次 loop 做了什么、卡在哪里、下一步是什么,就能无缝接上。第三层:Git Commit —— 可恢复的检查点
每个 loop 完成一个有意义的子目标后,我都要求 AI(或手动)做一次 git commit:```
feat(visuals): add MolecularNetwork D3 force-directed graph component
feat(data): add molecular interaction mock data for Yin Chen Hao Tang
fix(types): unify Node/Link type definitions across components
``commit message 本身就是一份"历史记录"——如果 AI 上下文丢了,git log --oneline` 能让它快速理解项目的演进过程。还有一个实战技巧:在启动一个高风险 loop 之前,先手动 commit 一个"安全点"。这样如果 loop 翻车了,一条
git reset --hard <commit-hash>就能回到翻车前的状态,也不用手动找哪些文件被改坏了。第四层:设计文档 —— loop 的"执行合同"
这是我的后端一次 loop 成功的核心。1500 行设计文档(技术方案 + API 契约 + 数据库设计)扮演了"合同"的角色:
- 技术方案(770 行):告诉 AI “用什么、怎么组织、为什么这么选”
- API 契约(402 行):告诉 AI “每个接口的输入输出长什么样”
- 数据库设计(376 行):告诉 AI “表结构、字段类型、关系怎么定义”
AI 不用完全理解业务逻辑,它只需要对着合同执行。每个字段类型、每个接口路径都有明确定义——
pytest通过就是通过,不通过就是不通过,没有模糊地带!这四层配合,在我手上能让 AI 在你不在的时候较为可靠地跑。3.9 中间会遇到的问题(以及我的解法)
讲了这么多方法论,但实际操作中问题远比理论多。以下是我踩过的坑和对应的解法:
问题 1:Token 用尽 / 上下文爆掉
现象: loop 跑了十几轮之后,AI 开始"忘记"之前的约定。比如前面写的代码用的是
camelCase,后面突然变成snake_case;或者前面定义的组件 props 类型,后面完全不认了。你我都知道,AI 的上下文窗口有限。随着对话越来越长,早期的重要信息会被压缩或丢弃。
解法:
- 限制单个 loop 的任务跨度(15-30 分钟)
- 把所有重要约束写入文件(CLAUDE.md / SPEC.md),而不是只在 prompt 里说
- 使用"接力式串联"——一个 loop 结束后,新 loop 从文件里读上下文,而非从对话历史里继承
问题 2:方向偏移——AI "自作聪明"或者想太多了
现象: 你让它写一个简单的列表组件,它顺手把整个页面重构了。或者你让它修复一个 CSS 问题,它把整个样式系统换成了 CSS-in-JS。
prompt 没有写"不要做什么"。AI 倾向于"多做"而不是"少做",因为它被训练为"尽可能有用"。
解法: 在 prompt 里显式写 Non-goals:```
目标:修复 MolecularNetwork 组件的 hover 样式问题Non-goals(不要做):
- 不要修改组件的数据结构
- 不要引入新依赖
- 不要重构其他组件
- 不要修改全局样式文件
```这一招非常有效。后来我每个 prompt 都会追加一个 Non-goals。问题 3:死循环——AI 反复修同一个 bug
现象: AI 修了一个 bug,引入了新 bug,再修新 bug,又引入另一个新 bug……无限循环。你早上醒来发现终端刷了几百行输出,代码反而比睡前更烂。
根因: 缺少"停止条件"和"回退机制"。现在的AI 没有"止损"的概念,它会一直试直到你关掉它。
解法:
- 在 prompt 里设置最大迭代次数:“如果 5 轮内测试不全绿,把问题写入 BLOCKED.md 然后停止”
- 记住 loop 的 recurring 任务最长 7 天后自动过期。如果发现 AI 陷入死循环,可以直接关闭终端杀掉整个会话——session 级别的 loop 随会话一起消失
- 最重要的一条:醒后先看 git diff,如果代码质量明显下降,果断 reset 到 loop 开始前的 commit
问题 4:依赖冲突——AI 引入了不该有的包
现象: 你项目用的是
d3@7,AI 引入了d3-force@3(旧版),导致类型冲突。或者你用pnpm,AI 跑了npm install。这是因为AI 不知道项目的依赖管理细节,或者没有先检查已有依赖。
解法: 在 CLAUDE.md 里写清楚:```
- 包管理器使用 pnpm(禁止使用 npm 或 yarn)
- 不要引入已有依赖的旧版本
- 添加新依赖前先检查 package.json 中是否已有同类库四、Prompt 模板 踩了几轮坑之后,我沉淀了几个模板。 4.1 组件开发模板``` 请创建 [组件路径和名称] 功能要求: 1. [具体功能点 1] 2. [具体功能点 2] 3. ... 技术约束: - 使用 [具体库和版本] - 遵循项目 CLAUDE.md 中的代码规范 - 暗色主题,使用 oklch 色彩空间 - 确保响应式(桌面 + 移动端) 验证标准: - pnpm type-check 通过 - 组件可独立渲染,无报错 - 代码不超过 [N] 行(超过说明需要拆分) ```4.2 后端 API 模板``` 请参考 docs/backend-api-contract.md 的接口契约, 实现 [具体 API 路由] 的完整功能。 分层要求: - Model(SQLAlchemy)→ Repository → Service → Route - Pydantic Schema 做请求/响应校验 - 统一响应格式 {success, data, message} 验证标准: - pytest 通过 - 符合 API 契约文档的请求/响应格式 ```4.3 Bug 修复模板``` 运行 [具体命令] 时出现以下错误: [粘贴完整错误信息] 请分析根因并修复。注意: - 不要猜测,先读相关代码再改 - 修复后运行 [验证命令] 确认 - 如果是设计问题而非 bug,写入问题文档并告诉我五、后端:一个 loop 拉通整个 FastAPI
这一章是我个人觉得最成功的 loop 使用案例。0din.ai 有一篇文章叫"While True: The Art of Unattended AI",把无人值守 AI 编码总结成"三支柱":Specs(明确规格)、Context(上下文管理)、Execution(可靠执行)。我的后端案例恰好是 Specs 足够强的典型。
是这样的
项目前端已经基本完成,但后端还是空的。比赛要求有完整的前后端。我写了一份详细的后端技术方案文档(
docs/backend-python-ai-spec.md,约 770 行),定义了:- 技术选型理由(为什么用 Python/FastAPI)
- 分层架构(Model → Repository → Service → Route)
- API 接口契约
- 数据库表结构
- 种子数据需求
执行过程
我给 AI 的 prompt 大意是:
请根据 docs/backend-python-ai-spec.md 的技术方案,以及 docs/backend-api-contract.md 的接口要求,实现完整的 FastAPI 后端。
要求:
- 完整的分层架构
- 所有 API 端点可工作
- 种子数据(4 用户 + 16 文章)自动加载
- pytest 测试通过
- 启动 uvicorn 后前端可正常对接
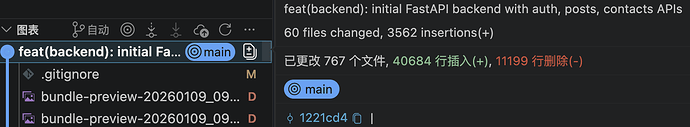
AI 用了一次 loop 就产出了整个后端,60 个文件,3500+ 行代码。Git 记录显示这是一个大 commit:```
feat(backend): initial FastAPI backend with auth, posts, contacts APIs60 files changed, 3562 insertions(+)
```
包含:
- 6 个数据库模型(User, Post, Tag, PostTag, Contact, AnalysisJob)
- 4 个 Repository(user, post, contact 的数据访问层)
- 4 个 Service(auth, post, contact, analysis 业务逻辑)
- 6 个 Route 模块(auth, users, posts, contacts, admin, analysis)
- 完整的 Pydantic Schema
- JWT 认证和权限系统
- 25 个测试用例(全部通过)
这里有个认知上的转变:AI 并没有从零"理解"整个后端设计。它做的是执行。我新开一个 cc,glm–4.7辅助我写了1500 行设计文档(770 行技术方案 + 402 行 API 契约 + 376 行数据库设计)把意图表达清楚了,剩下的就是 AI 的活。
回顾这次为什么这次成功了
回头看,这次能一次跑通有两个前提:文档够细,验证标准够明确。每个接口的输入输出、每个表的字段类型都有定义,pytest 通过就是通过,不通过就是不通过,没有模糊地带。
总结下就是:当项目目标存在强测试和一致性套件时,长程自主编码才变得可行。我的 1500 行设计文档 + 25 个 pytest 用例,就是那个"一致性套件"。
六、成果:最终项目数据
指标 |
数据 |前端源文件 |
45 个(.tsx/.ts/.css) |前端代码量 |
~7,800 行 |后端源文件 |
48 个(.py) |后端代码量 |
~3,500+ 行 |可视化组件 |
6 种(D3/ECharts/Three.js/Canvas) |博客文章 |
同事和我写的网药篇专业内容 |前端测试 |
29 passing |后端测试 |
25 passing |shadcn/ui 组件 |
15 个 |API 端点 |
12 个 |部署 |
前端 EdgeOne Pages + 后端 FastAPI |七、几条实战建议
1. 拆任务是写提示词的核心能力
一个模糊的"帮我做个网站"prompt,AI 大概率只能给你平庸的结果。把需求拆成 20 个精确的子任务,每个都有明确的输入输出和验证标准,AI 的输出质量会完全不一样。
2. 文档是 prompt 的一部分
别只在 prompt 里描述你要什么,写一份设计文档让 AI 读。我的后端能一次 loop 搞定,靠的就是 1500 行设计文档。用 0din.ai 的术语说,这叫 Spec-Driven Development——先有强规格,再让 AI 对着规格执行。
3. loop 的粒度要适中
改个按钮颜色不值得用 loop,手动更快。一次写整个项目也不行,AI 会迷失方向。一个可独立验证的功能模块,大约 15-30 分钟的 AI 工作量,是比较合适的粒度。
4. 睡前检查方向,醒后检查质量
loop 的价值在于异步。你睡觉的时候 AI 在干活。但前提是睡前确认 AI 的方向对了。我一般在启动 loop 后会看 2-5 分钟,确认 AI 理解了任务再走。第二天醒来第一件事是代码审查,不是测试通过就完事。
5. 翻车是常态,回退是美德
AI 写烂代码太正常了。在一个错误方向上费劲心思的反复修补是最慢的路。
git checkout .回退,换个 prompt 重新来,往往更快些。九、写在最后
这个项目从零到提交,大约花了 3天。如果纯手写,我估计至少需要1 多月。节省下来的时间,我用在了写设计文档、准备答辩、调整可视化效果上。
对我来说,AI 编程更像是一个不会累、不会抱怨、但需要清晰指令的搭档。它能执行到什么程度,取决于我的设计能力和拆解能力。项目质量的天花板在我这儿,不在它那儿。
这是我对我的一个项目的复盘,可能写得还有些粗陋,请海涵。
主楼 - 鸿岳2026-04-20
太厉害了佬,我看了一下去年4c25的作品,感觉佬拿个国奖轻轻松松 ^-^
- LONGSHENYIZU2026-04-20
哈哈,谢谢鼓励 ^-^,我新来 l 社不久,有一点开发心得,想积极跟大家分享一下我的用法 ^-^,拿不拿奖倒是是无所谓的,参与过程中已经学了不少,也巩固了不少技能 ^-^
- LONGSHENYIZU2026-04-20
现在的 glm-5.1,晚上loop 真的能爽蹬,你在睡觉,但是活干完了,真的很爽 ^-^
- leonsong2026-04-20
感谢分享,这种开发项目的经验对没系统做项目的人很有参考价值。
- yxhynmyt2026-04-20
感谢大佬的分享,写的很好。快下班了粗略读了下,回头在回顾,对我很有帮助!
- Alixy2026-04-20
没想到L站也能看到网络药理学啊,也是满满的回忆了 ^-^
- karl2026-04-20
文章太長,沒寫成skill,可能把你分享的餵給AI也不一定能重覆實現你的結果,還沒加上AI的隨機輸出
- U8仰望2026-04-20
这应该算是技术贴吧,帮楼主顶一下,大致了解loop了,下回也试试
- zeruel2026-04-20
很牛了,思路也很对。网络药理学主要就是清晰明了的展现各个信息中间的联系。loop机制设计的也不赖,偷了
- JackXu2026-04-20
- LONGSHENYIZU2026-04-21
我想分享的主要是面向人的一些经验分享^-^,是人function call的一些经验,这个给AI应该效果很不好,人不清楚使用方法的时候AI肯定是倾向于直接解决的,现在的大模型都被训练为尽可能的有用,但长程任务难保证的,所以想分享下我的复盘经验^-^
- emiyaLinux2026-04-21
这不是给人看的内容吗?有些东西还是需要给人掌握的,不是什么东西都要交给ai变成skills
- haihunHou2026-04-21
看起来loop真的能够充分利用人类晚上休息的时间
- Bugfish2026-04-21
牛啊佬,感谢分享,目前使用AI来完成项目开发就是要不断形成自己的方法论然后逐步优化,佬u的这套流程复盘启发很大
- Mercury-linuxdo2026-05-13
佬 我也参加了Web的赛道 我是全称Codex和Claude 这么快GLM5.1 也不错啊 哪个赛区的 有机会可以交流交流 说不定国赛遇见呢哈哈哈 线下面基一下 我下周省决答辩
- flomoc2026-05-13
飞书图片无法查看,需要权限才能添加进来。
- Zheng2026-10-05
是不是有点像cc的那个/goal模式?