- 月踏流云2026-10-06
 主楼
- MUK2026-10-06
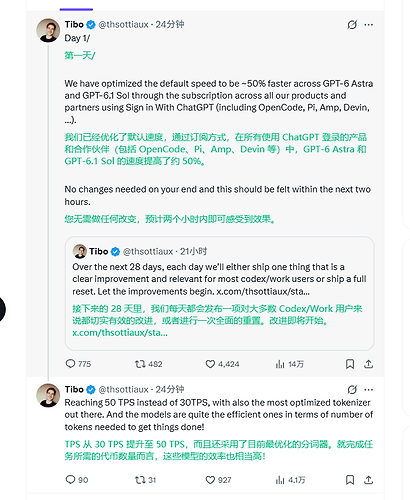
先降速再提速就是巨大优化,O\ 真是闹麻了 ^-^
- xephyrin2026-10-06
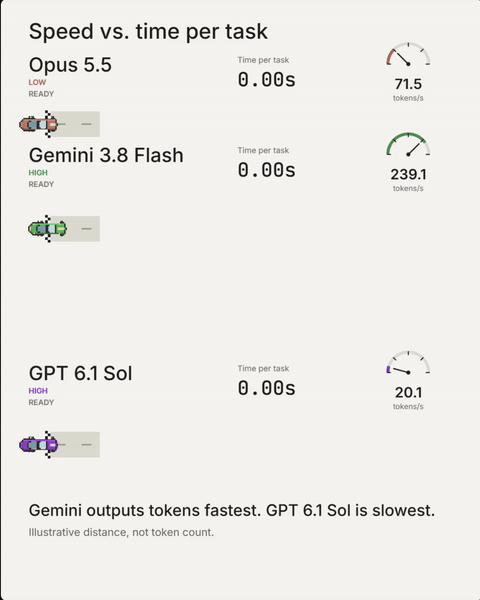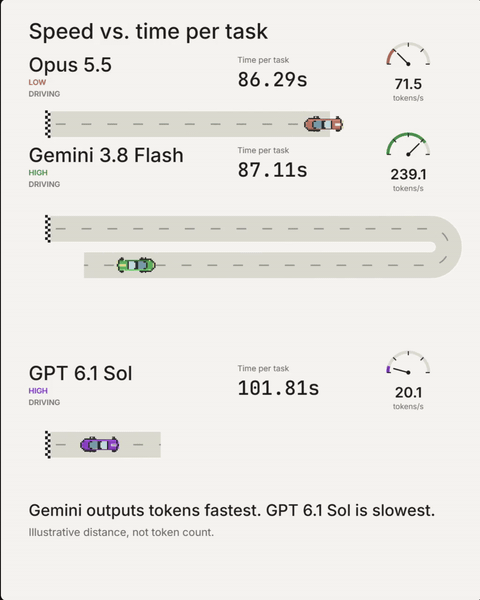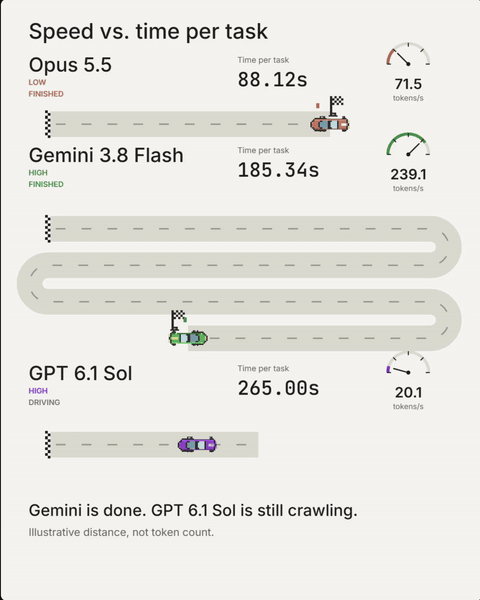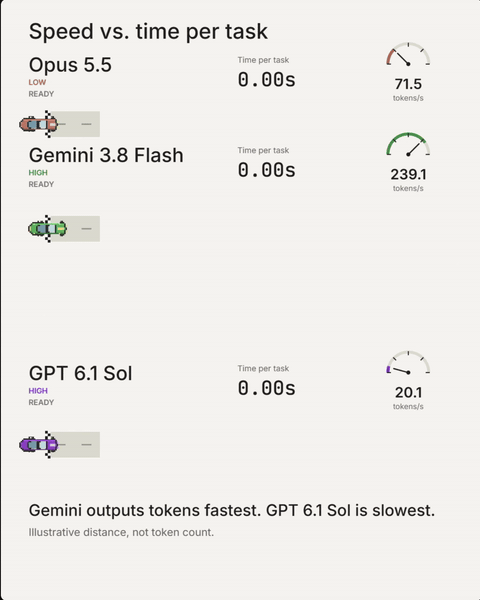
^-^不知道的还以为提升到500了呢,能不能来点flash模型啊,旗舰模型慢,高端模型慢中慢,低端模型更是慢中慢中慢
- 钟阮2026-10-06
- hoshumu2026-10-06
- KKoffice2026-10-06
- maximo2026-10-06
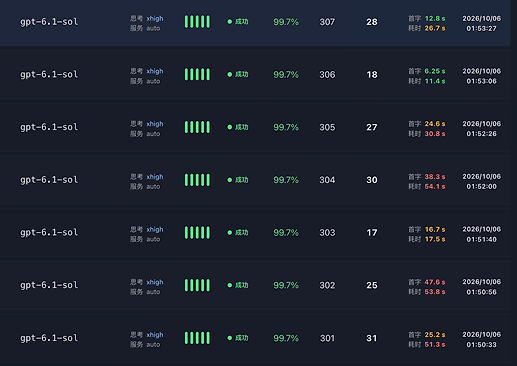
首字和tps都太高了 什么订阅啊这是
- 爱你们2026-10-06
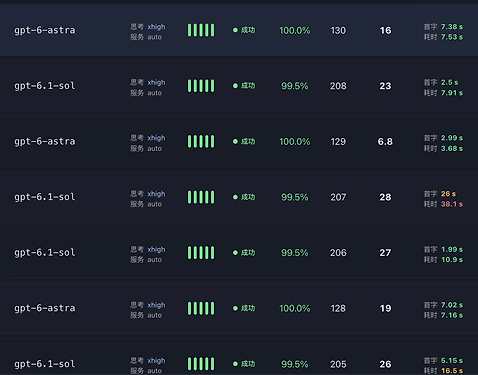
麻了,今晚开始6.1sol都要卡死了,我只能换到astra,又吹牛逼呢
- 钟阮2026-10-06
谷歌不是自研的TPU吗?DS好像是说硬件团队比较牛逼吧
- Kirafishy2026-10-06
闹麻了,想看看外国网友是怎么骂tibo的
- 赎梦2026-10-06
- maximo2026-10-06
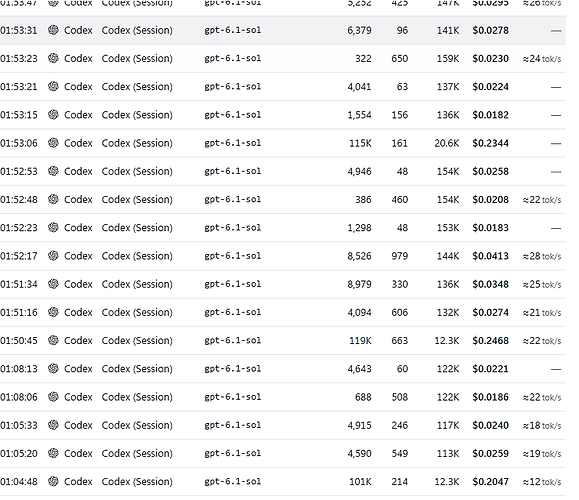
1tps -》 2tps 我还说提升2x呢 闹嘛了啊提拨
- 天怒2026-10-06
30tps是指单账号吗,前两天3任务6agent30tps
- lueluelue2026-10-06
30tps指的是fast吗
- lueluelue2026-10-06
tokenizer?看来openai真的不想换tokenizer了
- 魏笑2026-10-06
印象中,前半年github的copilot还是按次计费的时候,用的gpt模型速度记得很快呀,后来直接换到codex上,用gpt模型就感觉慢很多了。
- NInimo2026-10-06
感觉 ^-^好像是无思考的能到40-50toks也就是纯输出速度
- 月踏流云2026-10-06