- liuhua2026-10-14
上一篇应为AIGC没有用截图所以被举报删除了,现在所有正文都采用截图方式,声明一下:自己部署全程由opus5.5指导完成(我自己也是用了AI后实现了一些自己之前不敢想的事情),因此很多东西我也不能给你们一个准确的定论,希望大家可以自己稍微AI一下,我只能给大家我的配置的参考,opus5.5也帮我调优和调研很多版本后,并且e2e后才有这篇的内容,如果大家觉得AI生成的内容比不上你们手搓,觉得AI只是昙花一现,那我无话可说,而且这种专业的东西真怕误导大家了。
比如这篇文章,如果你的配置和我一样,那么其实直接下载下来给ds4.1-flash,完全就可以再30分钟内完成,大大减少大家的部署时间,即使你是其他配置也可以借鉴一下对吧?
管理手下留情谢谢!!!
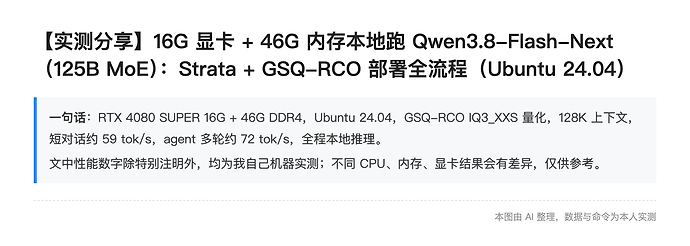
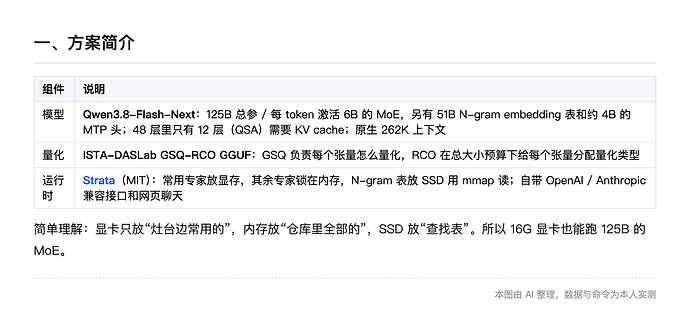
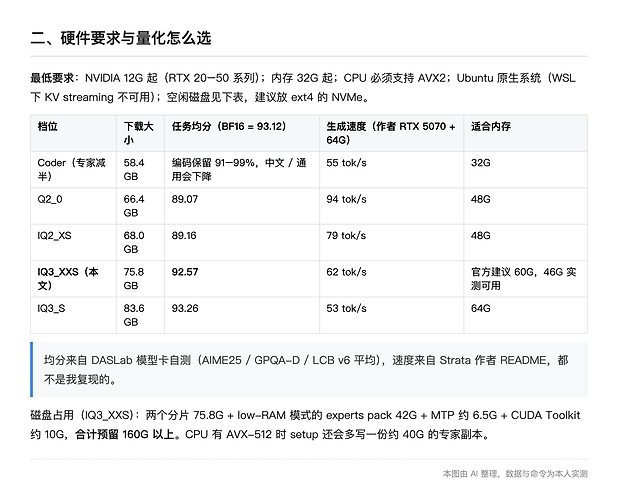
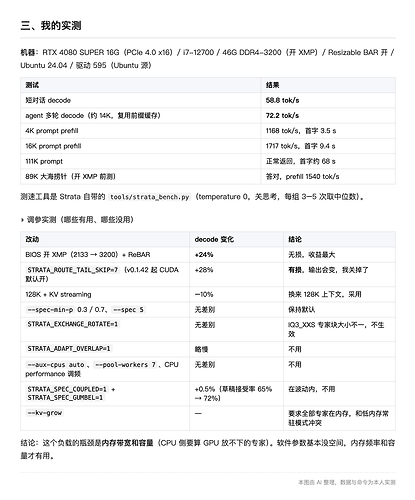
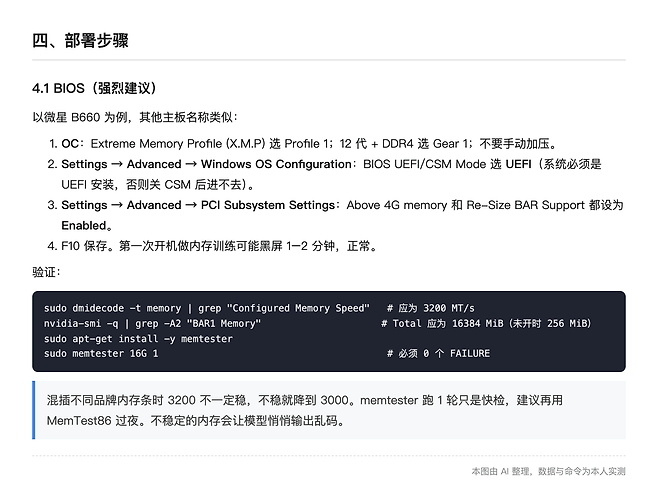
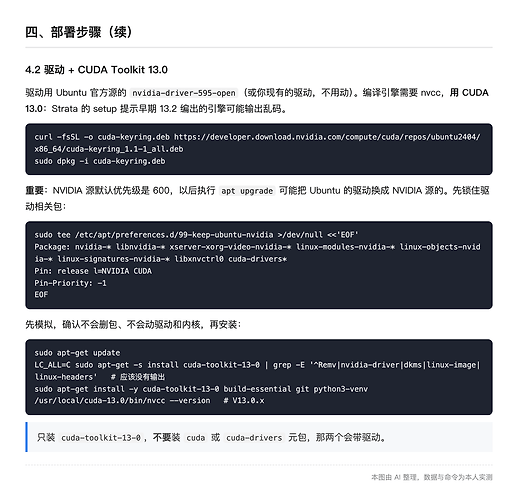
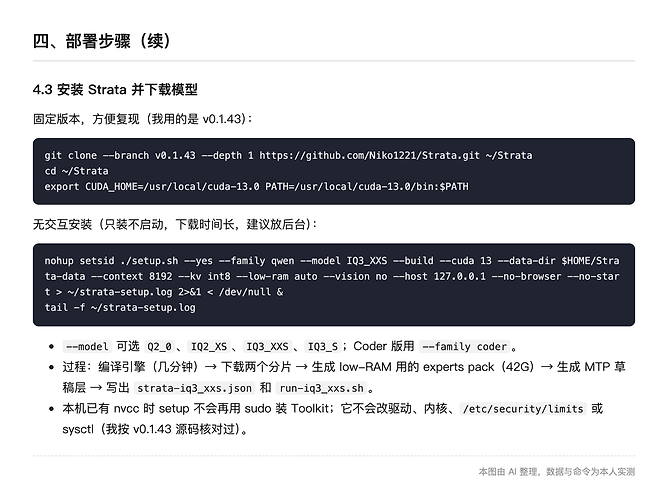
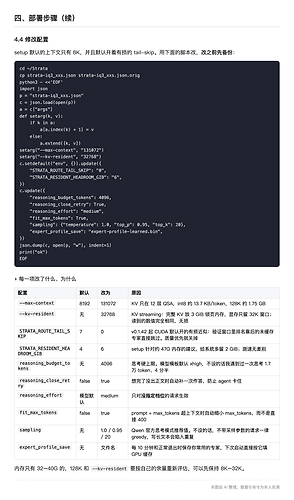
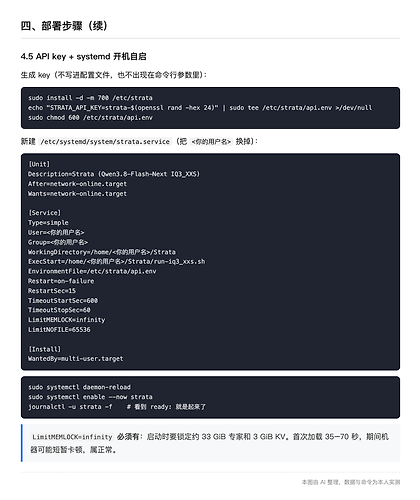
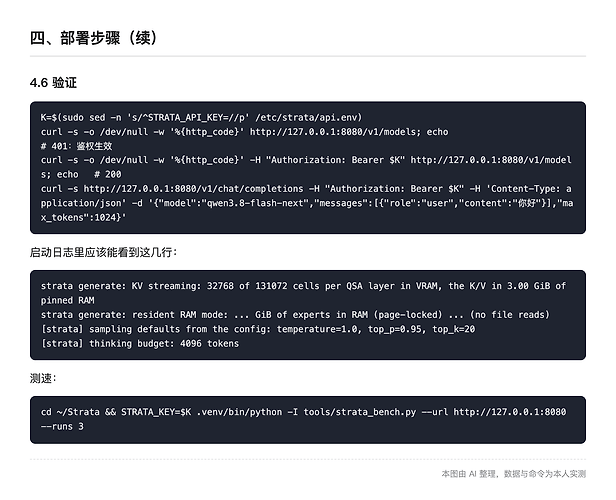
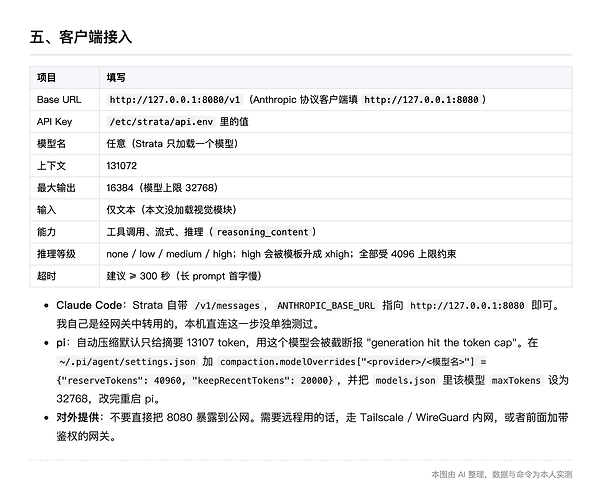
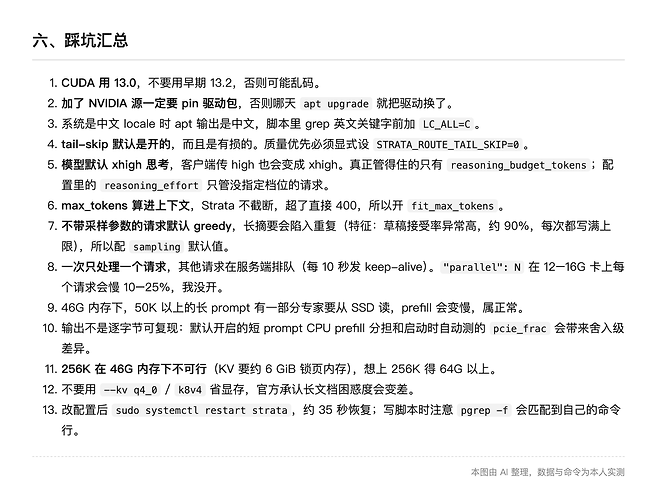
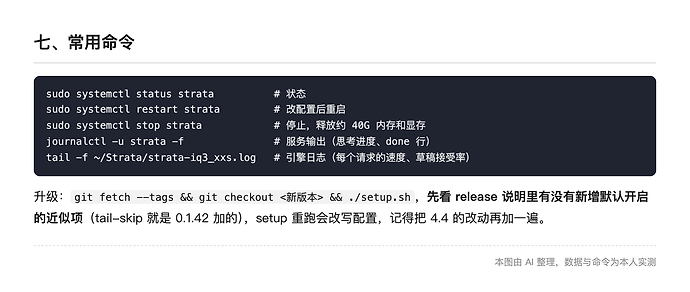
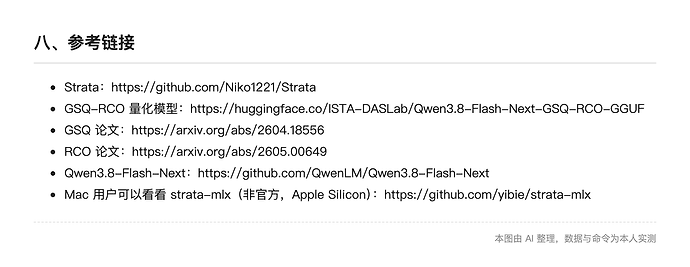
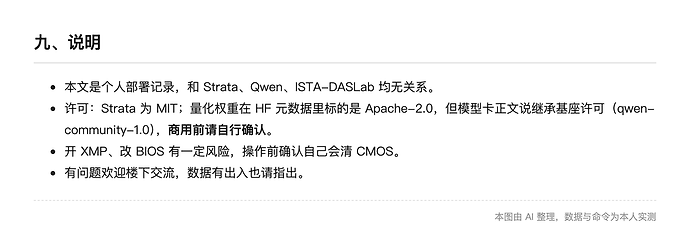
完整部署文档教程
github.com
GitHub - yxhpy/qwen3.8-flash-next-local-deploy: Qwen3.8-Flash-Next (125B MoE) 单卡 16G 本地部署实测:Strata...
Qwen3.8-Flash-Next (125B MoE) 单卡 16G 本地部署实测:Strata + GSQ-RCO IQ3_XXS,Ubuntu 24.04
实际部署用到的
github.com
GitHub - Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware:...
Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input.

GitHub
Release Strata v0.1.43 · Niko1221/Strata
Faster decode and prompts on NVIDIA, AMD and Intel, plus the fixes since 0.1.42. Decode is up to 38% faster on a 16 GB Radeon, 5-11% on RTX 30-series and Tesla P100 under Linux, up to 19% on four R...
github.com
GitHub - QwenLM/Qwen3.8: Qwen3.8 is the large language model series...
Qwen3.8 is the large language model series developed by Qwen team, Alibaba Group.
github.com
GitHub - QwenLM/Qwen3.8-Flash-Next: Qwen3.8-Flash-Next is the foundation model...
Qwen3.8-Flash-Next is the foundation model developed by Qwen Team, Alibaba Group.
github.com
GitHub - IST-DASLab/GSQ: Gumbel-Softmax post-training quantization for LLMs...
Gumbel-Softmax post-training quantization for LLMs (1–3 bit scalar, INT/GGUF-compatible).
github.com
GitHub - IST-DASLab/RCO: RCO: Optimization of Non-Decomposable Objectives...
RCO: Optimization of Non-Decomposable Objectives under Exact Budget Constraints for LLM Quantization and Pruning
github.com
GitHub - ggml-org/llama.cpp: LLM inference in C/C++
LLM inference in C/C++
github.com
GitHub - earendil-works/pi: AI agent toolkit: unified LLM API, agent loop,...
AI agent toolkit: unified LLM API, agent loop, TUI, coding agent CLI
huggingface.co
ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
主楼 - JARK0062026-10-14
不错,但是这类教程若真要跟着操作,大量的文本复制操作少不了,ocr也不完全正确,建议还是提供个md文件的链接
- jjxs2026-10-14
或者能不能卖ldc教程呢 就设置1ldc就行了 相信大家愿意支付1ldc
- liuhua2026-10-14
有的地方也是需要手动操作的,比如改BIOS的内容
- liuhua2026-10-14
哈哈,可以好主意
- Pokeman2026-10-14
先记录下试试,虽然没显卡
- wya-linuxdo2026-10-14
佬给个 GitHub 链接吧
- liuhua2026-10-14
已经更新到文章中了
- wya-linuxdo2026-10-14
佬我是说正文,这样方便复制
- Mai2026-10-14
部署了iq2xs,16+64G开图片识别256k,内存直接100%占满了。几年前让公司配的电脑,结果现在发现64也不够用^-^
- liuhua2026-10-14
试图可以关了,用其他模型
- liuhua2026-10-14
github.com
GitHub - yxhpy/qwen3.8-flash-next-local-deploy: Qwen3.8-Flash-Next (125B MoE) 单卡 16G 本地部署实测:Strata...
Qwen3.8-Flash-Next (125B MoE) 单卡 16G 本地部署实测:Strata + GSQ-RCO IQ3_XXS,Ubuntu 24.04
- Madmelon2026-10-14
部署了,32G+5060ti 16G,配合dsh速度确实快,但是还是经常爆上下文,或者输出爆了,我经常会搞开发任务,跑的久了就爆,佬有什么好方法吗 ?
- liuhua2026-10-14
我也经常爆,所以要提前压缩才行,或者压缩模型换成别的,我本地已经让opus帮我优化过了,大概就是提前压缩和换用在线模型压缩,但是考虑到是一些逆向任务所以我采用了提前压缩。
- Denial39382026-10-14
32G内存能跑点啥
- 力量型奶龙妈妈2026-10-14
感谢分享~闲时部署一个
 千鹤2026-10-14
先学习学习,等我机器弄好了,我也部署一个试试
- liuhua2026-10-14
嗯嗯,一定试试
- 火韦2026-10-14
收藏了学习了
- 做爱2026-10-14
添加视觉功能,用什么模型?