- 欣_郁2026-10-16
评估对象:Gemini 4 argon contributor(来自opencode go) vs deepseek-v4 flash+pro(来自opencode go)
评估方法来自本人自建的一套学术综述撰写流程:
- 检索指定主题(原发性膜性肾病的发病机制)的文献,构建文献材料库(共85篇,包括66篇pdf原文及19篇摘要);
- 将文献材料进行文本分块并向量化;
3.1 基于所有文献的摘要,写一个分点式的综述框架,题目为原发性膜性肾病的发病机制;
3.2 以综述框架的终末子标题为检索对象,利用RAG的方式检索文本块及图片;
3.3 每个“终末子标题+相关文本块”构成一个综述片段,组装综述片段即为成品综述。
比较维度:
- 生成综述大纲能力的评估:该任务为基于85篇文献摘要生成综述大纲,考察复杂长文本(约131k字符数,非token数)下模型的注意力和输出意愿;
- 综述整体的评估。
Gemini版中,Gemini 4负责生成大纲+综述片段。
deepseek版中,deepseek-pro负责生成大纲,deepseek-flash v4.1 负责生成综述片段(因为需要视觉能力)
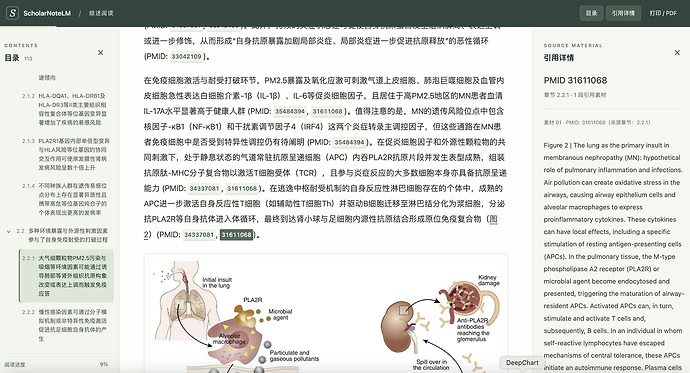
Gemini版综述示例:
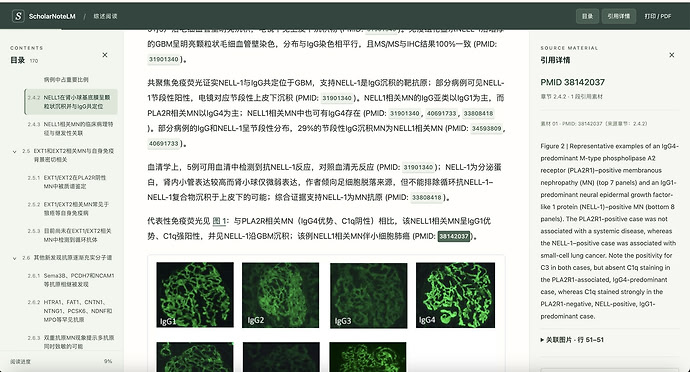
deepseek版综述示例:
结论:
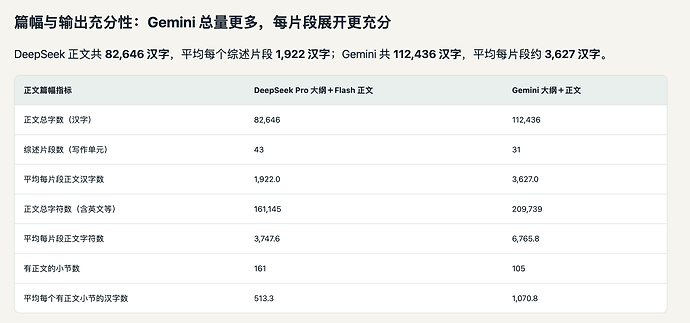
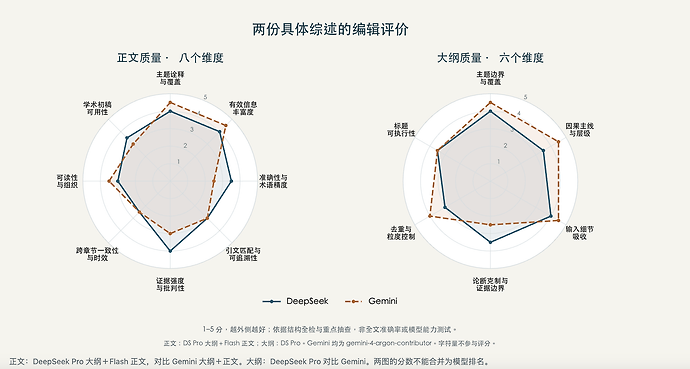
Gemini 4 argon contributor的机制主线连贯性、展开细致程度、输出意愿,综述可读性比deepseek强。
在事实核查领域里,在有相对廉价的(准)官方api的LLM中,Gemini 4 argon contributor是新的王者。
其他结论:
其他结论:本轮综述生成中,Gemini 4 argon contributor共接受2M字符数的input,输出380k字符数的思考摘要+256k字符数的正文内容(注意是字符,不是token),消耗量大致等于10刀opencode go的5h额度。
吐槽一下:opencode go真的很鸡贼,现在第三方agent中,每次对话需要加入特定请求头才能进行api调用了。
附录(完整测评报告+综述):
链接:https://pan.quark.cn/s/802543e59128
提取码:Jux3
主楼 - 南雅2026-10-16
挺好的出发点,忙完拜读一下佬的测评。
 drnleas5天前
这个阅读的UI界面也是gemini给你生成的HTML吗
- 欣_郁5天前
这是我自己的程序设置的格式
- 汤圆4天前
有测试gpt 和claude模型嘛
- 欣_郁3天前
没有;这两家的正规api太贵了