- sheric2026-07-31
根据智谱 套餐概览 - 智谱AI开放文档页面的计算,新pro套餐,在91%的缓存率下,能使用每周2.6到5.2亿的token,也就是每月10.4到20.8亿token。其中高峰期用量减半。
如果我们假设用户高峰期和非高峰期用量相等,那么就等于每个月15亿token。
15亿token,90%缓存,假设输出占全部的10%,按deepseek的定价模型 & 价格 | DeepSeek API Docs ,就等于450元的flash,或者1300的pro。
目前智谱的无优惠月定价是540,也就是假设glm-5.2和deepseek-v4-pro智力完全相同的情况下,套餐需要用到周限40%算不亏。
更新:上面的计算,对于智谱的token量是直接取官网宣传值。对于deepseek的输入输出比9:1是拍脑袋的。所以会感觉比实际使用贵。在此向看帖子感觉没算对的佬友道歉。
我核算了下,智谱宣传的token用量隐含的输入输入比是199:1。如果按199:1的输入输出比,ds-flash费用是190元,ds-pro费用是530元。在此情况下,只要deepseek和glm的token效率差不多,智谱套餐即使用满100%也没有优势。
主楼 - mango-linuxdo2026-07-31
- 一2026-07-31
目前v4pro预览版能力还是不够,而且没有套餐,api便宜是便宜但不能一概而论。要对比也应该是和kimi对比才对
- sheric2026-07-31
因为为了方便计算,假设输入输出比是9:1,缓存比是90%,deepseek的harness的缓存率和输入输出比可能比智谱更高。
- 翎2026-07-31
但是5.2代码能力比4pro要强啊
- sheric2026-07-31
kimi的token量没有非常官方的文档。而智谱文档给了token量。定价方面,deepseek虽然没有套餐,但是没有5h限、周限,加上不会过期。智力方面这个只能假定token效率一致不然没法对比。因为kimi是多模态大参数,也不适合直接与智谱比价。
- rc2026-07-31
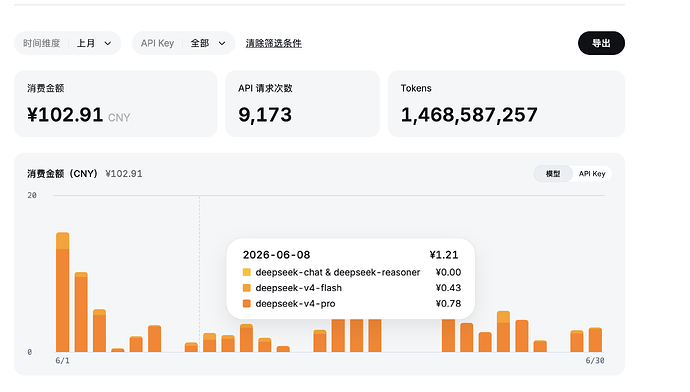
不能这样假设, 实际上这个量 在ds 就是一百多块 最多200块。 ^-^
- sheric2026-07-31
确实,我这个假设不太符合实际。我按照智谱宣传token量,反推了智谱假设的输入输出比为199:1,然后计算下来的deepseek成本确实减少了很多。更新在主贴了
- He1102026-07-31
这种比较没有什么意义,单个任务不同模型所需要的 Token 数量不同, Token 价格也不同,这么多变量怎么比较?而且不同模型完成不同任务所需的 Token 数,还跟 Harness 等各种设施有关,实际上这种比较没太大参考性。
我自己之前用过一百多 Deepseek Pro ,但是实际上产出很低,因为我的业务知识很多,但是模型的注意力太飘了,导致一直无法完整的完成任务,需要不断的纠正,即使价格便宜,实际上完成的任务成本也很高,尤其是多轮对话后,缓存的开销会非常高。
后面换更贵一点的模型之后,单次任务的成本反而降下来了,注意力足够强,任务不需要重复返工。
- Q_A2026-07-31
实际输入输出比可能更接近99:1,写代码的话